
Monte Carlo 数值计算与期权定价实战
导读:这篇教程能解决什么问题?
蒙特卡洛(Monte Carlo,简称 MC)是一类通过随机抽样估计数学期望的数值方法。在衍生品定价中,常见做法是在风险中性测度下生成未来市场状态,计算每条路径上的合约现金流,再对这些现金流的现值求平均。
DolphinDB 新增的通用 MC 工具函数将这一流程拆解为三个可复用的函数:
-
mcSimulate:按照自定义状态转移规则生成随机路径。 -
mcEstimate:对已经得到的收益或其他样本计算均值、方差、标准误与置信区间。 -
monteCarlo:把路径生成、Payoff 计算和统计汇总整合到一个调用中。
这使得使用者无需为每一种期权重新编写随机数生成、相关性转换、批量计算和统计聚合逻辑,而可以集中定义两个问题:市场状态如何演化?产品在什么条件下支付多少钱?
本教程依次讲解 GBM 随机过程、欧式期权、亚式期权、障碍期权、回望期权、两资产期权、Heston 随机波动率以及雪球示例,并讨论历史 Fixing、估值误差、对偶变量和性能测试。本教程示例代码需要运行在 DolphinDB Server 3.00.6.4 及以上版本。
贯穿全文的约定: 示例价格以单位名义本金或单位期权合约计;r 和 q 分别表示连续复利无风险利率和连续股息收益率;时间以年计;sigma 为年化波动率;DolphinDB 脚本使用零基索引。除特殊说明外,以下示例按常数利率、常数参数、无交易成本、风险中性定价演示。回调函数中直接返回已折现的路径收益,因此 monteCarlo 返回值就是当前估值。
阅读路径
| 读者目标 | 建议章节 |
|---|---|
| 10 分钟理解计算框架 | 第 1—2 章 |
| 开始运行 DLang 蒙特卡洛代码 | 第 3—4 章 |
| 处理 Asian / Barrier / Lookback | 第 5—6 章 |
| 实现相关资产及随机波动率模型 | 第 7—8 章 |
| 处理存续期和结构化产品状态 | 第 5.4 节、第 9 章 |
| 做模型验证与性能报告 | 第 10—11 章 |
1. Monte Carlo 定价原理
1.1 从期权价值到数学期望
在能够使用风险中性定价框架且相关可积性与无套利条件成立时,未来时刻 T 支付 H(ST) 的欧式衍生品,其估值时点 t 的价值为:
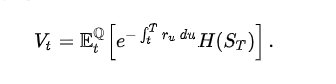
若利率为常数 r,公式简化为:
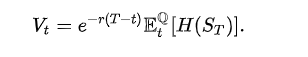
蒙特卡洛方法模拟 N 条风险中性样本路径,以现金流现值 Yi 计算:
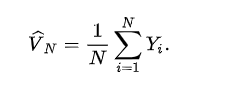
对于路径依赖期权,可把 H(ST) 替换为 H(St0,...,Stm) ;若发生多笔支付,则每条路径需将所有现金流按照实际支付时间折现并求和:
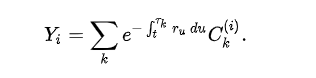
这也是理解 payoff 回调的关键:它不必只返回到期日现金流,也可以返回整条路径上各期现金流现值的合计。
1.2 以 GBM 为例构造风险中性路径
假设股价服从几何布朗运动(Geometric Brownian Motion, GBM):
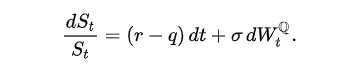
对一个时间间隔 Δt,GBM 可以精确离散为:
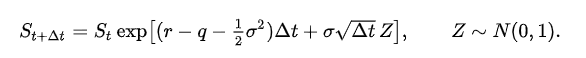
这里的 Z 是标准正态随机数,不是已经乘过 √Δt 的布朗运动增量。新函数传给 evolve 的
noise 正是这一形式,因此用户要在 evolve 中显式处理时间尺度。
在常参数 GBM 下,采用上述指数形式可以避免使用简单 Euler 更新时股价可能变为负值的问题,也有助于区分纯粹采样误差与时间离散误差。
1.3 标准误与置信区间
令 Y1,...,YN 是独立、同分布并具有有限方差的折现收益样本,则样本方差为:
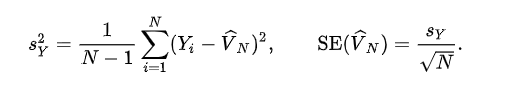
在适当的中心极限定理条件下,95% 正态渐近置信区间为:
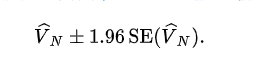
Monte Carlo 的统计误差通常按 O(N⁻¹/²) 缩小:若希望标准误降低到原来的十分之一,其他条件不变时往往需要约一百倍的有效独立样本。这是概率采样误差的收敛规律,不意味着使用有限时间步模拟 SDE 的离散偏差也会随路径数减小。
1.4 Monte Carlo、解析法与 PDE 的分工
| 方法 | 主要优势 | 主要限制 | 典型产品 |
|---|---|---|---|
| 解析法 | 快速、无采样误差,适合基准验证 | 模型与 Payoff 的适用范围有限 | BS 欧式期权、Margrabe 交换期权 |
| PDE / FDM | 低维问题可求完整价值面,便于处理部分边界与提前行权 | 维数升高时网格规模迅速增长 | 欧式、美式及部分障碍产品 |
| Monte Carlo | 容易模拟高维风险因子、复杂现金流和路径依赖 | 存在采样误差;提前行权需要额外最优停止算法 | Asian、Basket、Heston、雪球类路径依赖产品 |
边界提醒: 通用 monteCarlo 接口本身不内置 American/Bermudan 最优停止求解器;若要求解提前行权价值,需要自行实现 Longstaff–Schwartz 等额外算法,并独立验证。
2. Monte Carlo 函数体系
2.1 整体架构
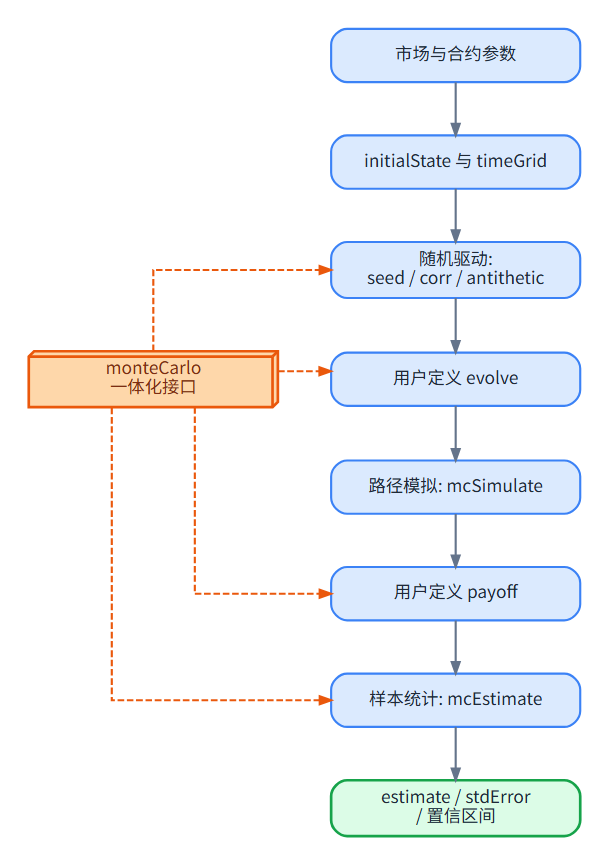
两条典型工作流分别是:
-
研究与调试型:
mcSimulate → 自定义处理 → mcEstimate。能够检查路径及随机数,但完整路径可能消耗较大内存。 -
业务定价型:
monteCarlo(evolve, payoff, ...)。函数内部按批次推进模拟并汇总结果,适合固定 Payoff 的批量数值估计。
2.2 函数介绍
| 函数 | 接口 | 主要返回 | 适合场景 | 官方文档 |
|---|---|---|---|---|
mcSimulate |
mcSimulate(evolve, initialState, timeGrid, numPaths, [numFactors=1], [params], [options]) |
paths、timeGrid、seed 等字典字段 | 研究随机过程、路径检查 | mcSimulate |
mcEstimate |
mcEstimate(samples, [confidenceLevel=0.95]) |
estimate、variance、stdError 等 | 已有样本的统计估计 | mcEstimate |
monteCarlo |
monteCarlo(evolve, payoff, initialState, timeGrid, numPaths, [numFactors=1], [params], [options]) |
详细统计字典或仅估计值 | 完整 MC 估值流程 | monteCarlo |
mcSimulate 不计算合约价格;mcEstimate 不生成随机路径;monteCarlo 不自动理解金融合约含义。现金流、折现、税费、行权、观察日及历史已发生事件均由用户根据产品条款定义。
2.3 与 DolphinDB 专用金融定价函数的关系
通用 MC 函数和 eqEuropeanOptionPricer 等产品专用函数并不是替代关系。后者针对既定金融产品、Instrument 与市场数据约定封装业务模型;前者提供更底层的通用随机数值求解能力。对于标准产品,可优先使用专用定价函数,并将 MC 实现用于模型研究、创新结构验证或独立估值对照。
FICC 与 Equity 定价函数使用教程 和 eqEuropeanOptionPricer 可作为标准产品的扩展阅读。
2.4 适用范围
支持:标准正态伪随机驱动;单状态/多状态;单因子/多因子;相关矩阵;完整路径和终值模式;多输出 Payoff;对偶变量法;批处理;单节点 CPU 批次并行;均值、无偏样本方差、标准误与正态渐近置信区间。
暂时不支持:GPU 计算、跨节点分布式 MC 调度、Sobol/QMC、控制变量法、Brownian bridge 连续障碍修正、American/Bermudan 最优停止算法、模型参数校准及 Greeks 自动微分。
3. 随机路径生成与样本统计入门
3.1 第一个 mcSimulate 案例:生成 GBM 路径
下面用 12 个等长时间步模拟 8 条价格路径。
// 示例 3-1:GBM 路径模拟
// 时间单位为年;返回每个时间节点所有路径的状态矩阵
def gbmEvolve(t, state, dt, noise, p) {
    mu = (p["r"] - p["q"] - 0.5 * p["sigma"] * p["sigma"]) * dt
    return state * exp(mu + p["sigma"] * sqrt(dt) * noise)
}

p = dict(STRING, DOUBLE)
p["r"] = 0.03
p["q"] = 0.0
p["sigma"] = 0.20

opt = dict(STRING, ANY)
opt["seed"] = 7
opt["batchSize"] = 8
opt["returnRandomNumbers"] = true

sim = mcSimulate(gbmEvolve, 100.0, 0..12 / 12.0, 8, 1, p, opt)
print(size(sim["paths"]))           // 13:包含 t=0
print(shape(sim["paths"][0]))      // 8:1:8 条路径、1 个状态
print(size(sim["randomNumbers"])) // 12:12 个随机驱动切片
print(sim["paths"][12])           // 终值矩阵
sim["paths"][i] 表示第 i 个时间节点全部路径的状态,不是一条路径的完整时间序列。要查看某条路径,可以依次读取各时点矩阵的同一行。正式生产中如果只需要期权价格,通常不应先把数百万条完整路径全部返回到客户端。
实测输出:
-
paths 数量:13
-
首个节点形状:[8, 1]
-
随机数切片数:12
-
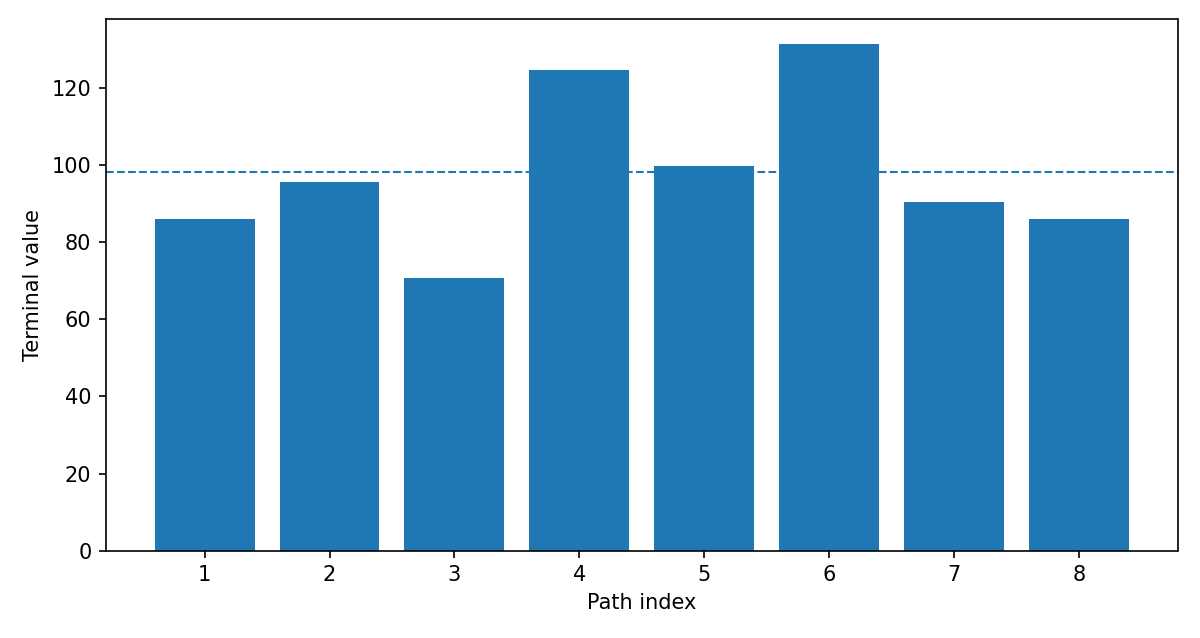
8 条样本路径终值: [86.07027033, 95.76439369, 70.83725030, 124.81301557, 99.78994602, 131.41412373, 90.49519174, 86.17040506]
下图给出了这 8 条样本路径的终值分布。由于这里只是教学型小样本演示,图形不用于统计结论,而是用于帮助理解 mcSimulate 输出结构。
3.2 独立使用 mcEstimate
// 示例 3-2:简单统计估计
stats = mcEstimate(1.0 2.0 3.0 4.0 5.0)
print(stats["estimate"])     // 3
print(stats["variance"])     // 2.5,分母为 4
print(stats["stdError"])     // sqrt(2.5/5) = 0.70710678
print(stats["sampleCount"])  // 5

// 两列:每列独立估计一个目标
samples = matrix(1.0 2.0 3.0 4.0, 10.0 20.0 30.0 40.0)
multi = mcEstimate(samples, 0.99)
print(multi["estimate"])     // [2.5, 25]
这里的 mcEstimate 只知道输入数据是数字样本,并不知道它们来自哪一种期权。如果输入的是折现收益,则估计值可解释为价格;如果输入的是股票终值,估计值就是股票终值的期望。
| 统计对象 | 结果 |
|---|---|
| estimate | 3.0 |
| variance | 2.5 |
| stdError | 0.7071067811865476 |
| sampleCount | 5 |
| 多列 estimate | [2.5, 25.0] |
这个结果验证了 mcEstimate 使用无偏样本方差与基于样本数的标准误定义,与文中的理论说明一致。
3.3 一次性求解: monteCarlo
通用定价的基本模式如下:
// 已在本节上方定义 gbmEvolve 和 p
// 按自己的产品定义合适的收益函数
def callPayoff(terminalState, timeGrid, p) {
    terminal = terminalState[, 0]
    T = timeGrid[size(timeGrid) - 1] - timeGrid[0]
    return exp(-p["r"] * T) * max(terminal - p["K"], 0.0)
}
p["K"] = 100.0

mcOpt = dict(STRING, ANY)
mcOpt["seed"] = 42
mcOpt["antithetic"] = true
mcOpt["batchSize"] = 2000
mcOpt["pathMode"] = "terminal"
mcResult = monteCarlo(gbmEvolve, callPayoff, 100.0,
    0..12 / 12.0, 20000, 1, p, mcOpt)
print(mcResult["estimate"])
print(mcResult["stdError"])
print(mcResult["confidenceLower"])
print(mcResult["confidenceUpper"])从这一节开始,所有示例都采用相同逻辑:通过
evolve 定义模型,通过 payoff 定义产品,通过 options 控制数值计算。不同产品的主要区别集中在模型与现金流逻辑,而不是 MC 引擎调用方式。
| 指标 | 数值 |
|---|---|
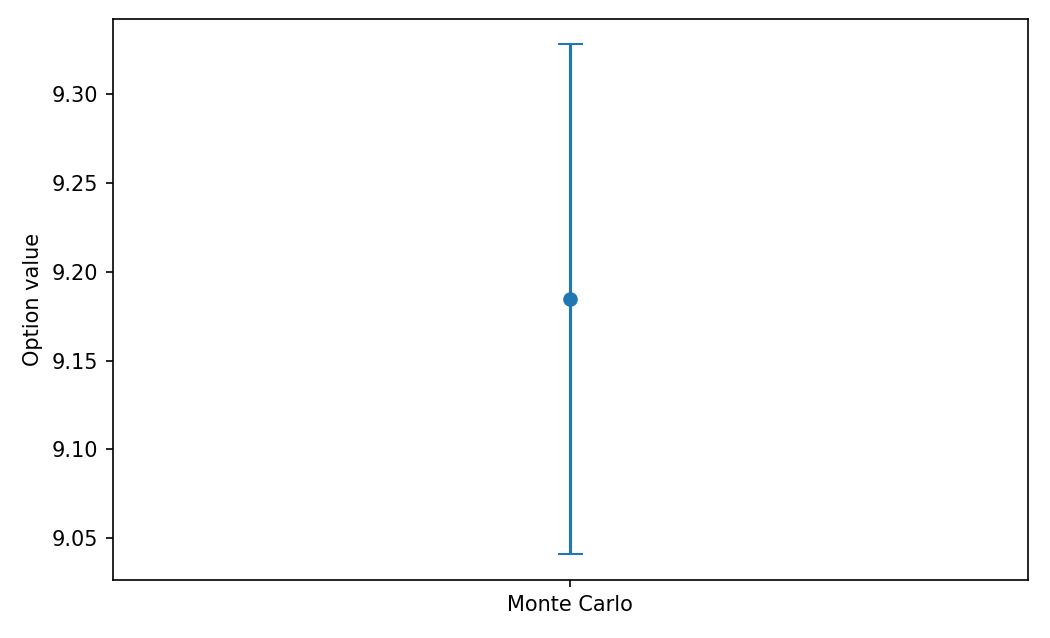
| estimate | 9.184365113062904 |
| stdError | 0.073151245422059 |
| confidenceLower | 9.040991306611417 |
| confidenceUpper | 9.32773891951439 |
这组结果清楚展示了 monteCarlo 的一体化返回结构:不仅给出价格估计,还直接给出标准误和置信区间。
4. 欧式期权:从 Monte Carlo 到 Black–Scholes 验证
4.1 产品定义与解析基准
欧式看涨与看跌期权的到期收益分别为:
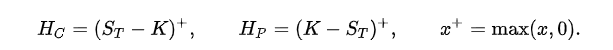
假设 GBM 且 r, q, σ 为常数,Black–Scholes–Merton 解析价为:
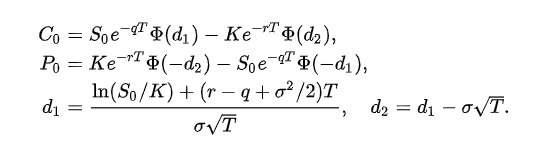
其中 Φ 为标准正态分布函数。Call/Put 的解析价值使它们成为 MC 框架首选的正确性对比基准。
4.2 完整 DLang 案例:一次计算 Call、Put 和 Digital
此例返回三列:看涨、看跌和支付 1 元的现金或无(cash-or-nothing)数字看涨期权。与单独启动三轮模拟相比,多输出接口更易使用相同的模拟路径和模型参数保持结果可比。
// 示例 4-1:三种欧式期权的蒙特卡洛估值与解析对照
def gbmEvolve(t, state, dt, noise, p) {
    drift = (p["r"] - p["q"] - 0.5 * p["sigma"] * p["sigma"]) * dt
    return state * exp(drift + p["sigma"] * sqrt(dt) * noise)
}

def vanillaPayoff(terminalState, timeGrid, p) {
    ST = terminalState[, 0]
    T = timeGrid[size(timeGrid) - 1] - timeGrid[0]
    df = exp(-p["r"] * T)
    callPV = df * max(ST - p["K"], 0.0)
    putPV = df * max(p["K"] - ST, 0.0)
    digitalPV = df * iif(ST > p["K"], 1.0, 0.0)
    return matrix(callPV, putPV, digitalPV)
}

p = dict(STRING, DOUBLE)
p["S0"] = 100.0
p["K"] = 100.0
p["r"] = 0.03
p["q"] = 0.0
p["sigma"] = 0.20

opt = dict(STRING, ANY)
opt["seed"] = 42
opt["antithetic"] = true
opt["batchSize"] = 10000
opt["pathMode"] = "terminal"
result = monteCarlo(gbmEvolve, vanillaPayoff, p["S0"],
    0..12 / 12.0, 100000, 1, p, opt)

T = 1.0
d1 = (log(p["S0"] / p["K"]) + (p["r"] - p["q"] +
      0.5 * p["sigma"] * p["sigma"]) * T) / (p["sigma"] * sqrt(T))
d2 = d1 - p["sigma"] * sqrt(T)
bsCall = p["S0"] * exp(-p["q"] * T) * cdfNormal(0.0, 1.0, d1) -
         p["K"] * exp(-p["r"] * T) * cdfNormal(0.0, 1.0, d2)
bsPut = p["K"] * exp(-p["r"] * T) * cdfNormal(0.0, 1.0, -d2) -
        p["S0"] * exp(-p["q"] * T) * cdfNormal(0.0, 1.0, -d1)
bsDigital = exp(-p["r"] * T) * cdfNormal(0.0, 1.0, d2)

print(result["estimate"])          // [Call, Put, Digital]
print(result["stdError"])          // 每列标准误
print([bsCall, bsPut, bsDigital]) // 三个解析基准
print(result["estimate"] - [bsCall, bsPut, bsDigital])

// 带统计容差的检验,而非对随机估计使用固定小数位断言
assert 1, all(abs(result["estimate"] - [bsCall, bsPut, bsDigital]) <=
              4.0 * result["stdError"])
这里 cdfNormal(0.0, 1.0, x) 表示均值为 0、标准差为 1
的正态分布累积分布函数。Digital 的严格不等号 ST > K 对连续
GBM 终值的理论价格无影响,但离散模型、带原子分布的资产模型需明确等于行权价时的支付规则。
理解运行结果: MC 价格不需要与解析结果小数点后每位完全相同。判断差异是否异常,需要结合标准误、随机种子、采样次数和模型约定。另可检查欧式期权平价:
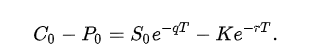
由于 Call 和 Put 采用同一批终值路径,其联合检验还可以用于发现贴现或股票漂移的实现错误。
4.2.1 实测结果与解析对照
实测结果:
| 产品 | Monte Carlo 估计值 | 标准误 | 解析值 | 差值(MC - 解析) |
|---|---|---|---|---|
| European Call | 9.4148672684 | 0.0330891097 | 9.4134033839 | +0.0014638846 |
| European Put | 6.4648660006 | 0.0212761015 | 6.4579567387 | +0.0069092619 |
| Digital Call | 0.5035738918 | 0.0004139515 | 0.5045722918 | -0.0009984000 |
从本组结果看:
-
Call 与 Put 表现良好,差值均处于合理的统计波动范围内;
-
Digital 的绝对差值较小,但相对于标准误偏大,说明该类非光滑 Payoff 对路径数和随机抽样更敏感;
-
这也提醒我们:判断 MC 是否“准确”不能只看绝对差值,还要结合标准误和产品特性一起判断。
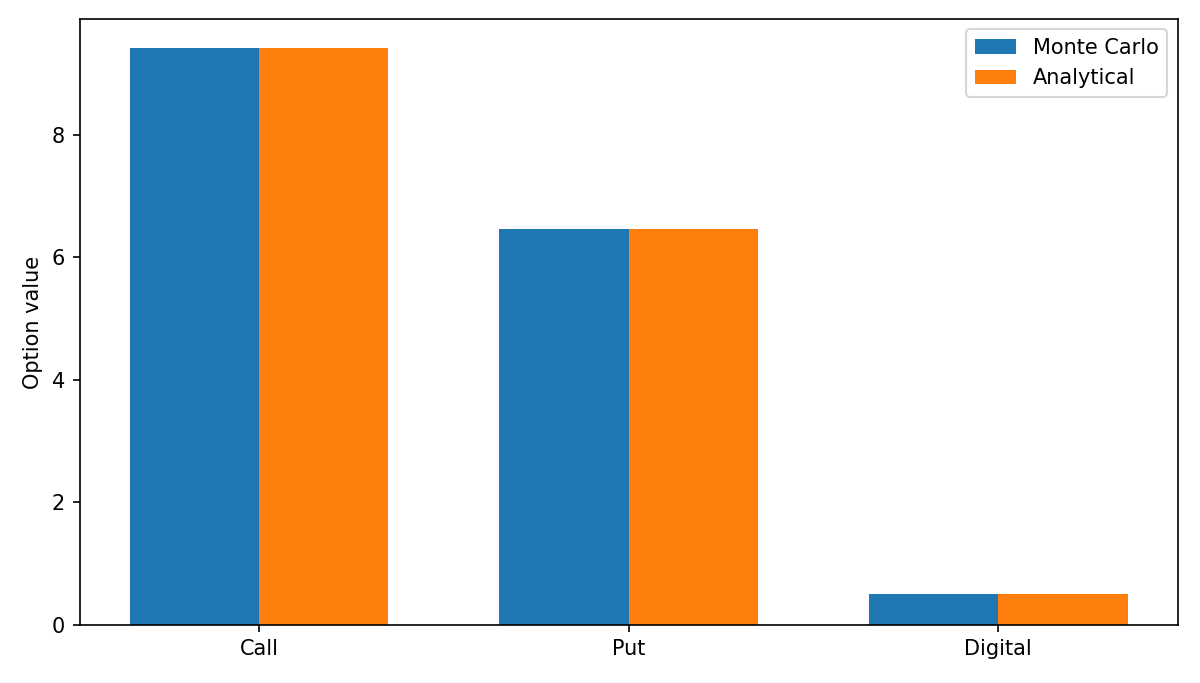
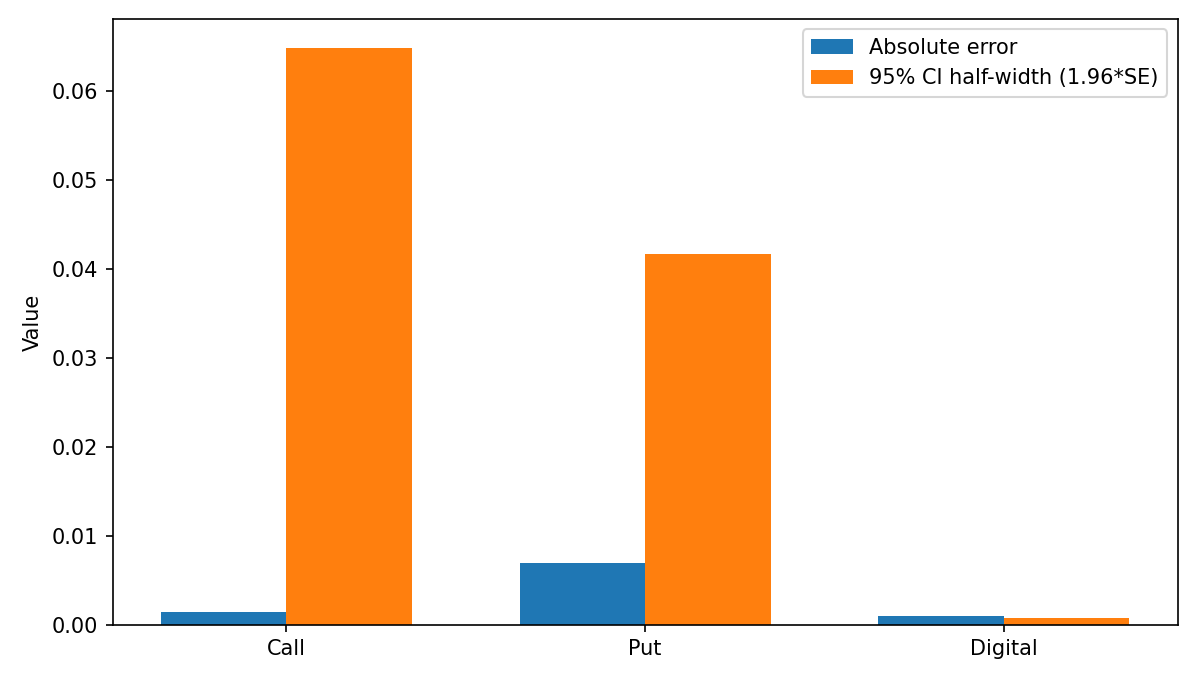
图 4-2 用绝对误差与 1.96 × stdError 的 95% 置信区间半宽进行对比。Call 和 Put 的误差明显处在统计容差内;Digital 的误差相对于标准误更突出,因此在正式验证中建议通过增加路径数、复用多个种子以及检查边界支付定义进一步复核。
4.3 为什么使用 terminal 模式?
标准 GBM 欧式期权只需要 ST。如果调用 full
(即保存全部模拟路径),引擎必须维护每个时间节点的批次路径;使用 terminal 可以避免保存对 Payoff
无用的中间时点。在仅需终值、模型又支持直接从 t=0 演化至 t=T 时,也可以只使用两个时间点( 0.0 和 1.0),减少不必要的状态更新。这里保留 12
步,是为了与后续路径依赖案例保持教学上的一致性。
4.4 本章实践延伸
可以只修改 vanillaPayoff,进一步实现 Straddle、Strangle、Butterfly、Bull Spread、Asset-or-Nothing 等组合。需要注意的是,多个合约 Payoff 可以共用路径,但多列结果默认只提供各自的标准误,不直接提供组合价格协方差矩阵。若研究组合风险,应在独立样本框架下保留各列现金流以估计相关性。
5. 亚式期权:平均价格、路径依赖与历史 Fixing
5.1 亚式期权为什么需要完整路径?
离散算术平均和几何平均价格分别定义为:
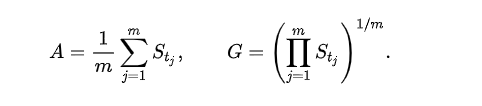
对应的固定行权价看涨期权收益为 (A-K)+ 与 (G-K)+。与欧式期权只依赖 ST 不同,它们需要指定每个 Fixing 时点、Fixing 权重及已经发生的历史价格。这里假设每个月末观察一次,共 12 次,不把初始时间点 t=0 计入平均值。
5.2 完整 DLang 案例:同一批路径计算两种 Asian
// 示例 5-1:12 次月末观察的算术/几何平均亚式看涨期权
def gbmEvolve(t, state, dt, noise, p) {
    drift = (p["r"] - p["q"] - 0.5 * p["sigma"] * p["sigma"]) * dt
    return state * exp(drift + p["sigma"] * sqrt(dt) * noise)
}

def asianPayoff(paths, timeGrid, p) {
    n = rows(paths[0])
    m = size(paths) - 1
    // 只用未来 12 个观察时点,不含 t=0
    prices = matrix(DOUBLE, n, m)
    for (i in 1..m) {
        prices[, i - 1] = paths[i][, 0]
    }
    arithmeticAverage = rowAvg(prices)
    geometricAverage = exp(rowAvg(log(prices)))
    T = timeGrid[size(timeGrid) - 1] - timeGrid[0]
    df = exp(-p["r"] * T)
    return df * matrix(max(arithmeticAverage - p["K"], 0.0),
                       max(geometricAverage - p["K"], 0.0))
}

p = dict(STRING, DOUBLE)
p["r"] = 0.03
p["q"] = 0.0
p["sigma"] = 0.20
p["K"] = 100.0
opt = dict(STRING, ANY)
opt["seed"] = 42
opt["antithetic"] = true
opt["batchSize"] = 5000
opt["pathMode"] = "full"
res = monteCarlo(gbmEvolve, asianPayoff, 100.0,
    0..12 / 12.0, 100000, 1, p, opt)
print(res["estimate"])       // [算术 Asian, 几何 Asian]
print(res["stdError"])
同路径下,正价格序列满足 A ≥ G,因而对于同一行权价和同样的观察日,逐路径都有 (A-K)+≥(G-K)+。这为代码提供了直观的合理性约束。
5.3 如何用几何平均亚式的解析解验证?
在常参数 GBM 下,ln G 服从正态分布。对于确定的观察时间 t1,...,tm:
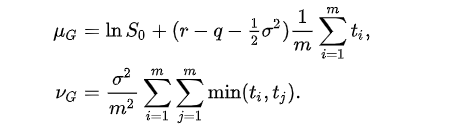
于是:
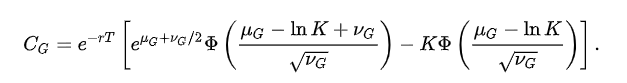
验证的前提是观察时间完全一致。如果一个实现平均 12 次月末 Fixing,而另一个实现包含 t=0 或采用日度 Fixing,其解析值与模拟值不能直接比较;这也是跨库 Asian 定价差异最常见的原因之一。算术平均 Asian 通常没有这种通用的简单闭式解,可以使用高路径数独立 MC、收敛性检验或更专门的数值方法验证。
5.4 存续期定价:如何加入已经发生的历史价格?
假设一个 12 次观察的 Asian,估值时前 6 次 Fixing 已经确定,接下来的 6 次还未发生。平均价应写为:
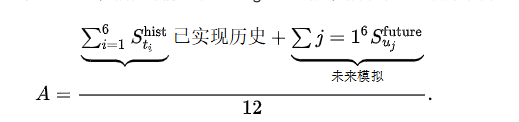
历史的充分统计量可以是
realizedSum、realizedCount;如果产品要求审计追溯,也可以在外部保留完整
Fixing 序列。monteCarlo 不会为用户自动恢复历史观察值。
// 示例 5-2:存续期 Asian,已有 6 次观察,未来再观察 6 次
def gbmEvolveHist(t, state, dt, noise, p) {
    drift = (p["r"] - p["q"] - 0.5 * p["sigma"] * p["sigma"]) * dt
    return state * exp(drift + p["sigma"] * sqrt(dt) * noise)
}

def seasonedAsianPayoff(paths, timeGrid, p) {
    n = rows(paths[0])
    futureSum = take(0.0, n)
    futureCount = size(paths) - 1
    // 从估值日后的第一个待观察日开始,不重复计入当日价格
    for (i in 1..futureCount) {
        futureSum += paths[i][, 0]
    }
    averagePrice = (p["realizedSum"] + futureSum) /
                   (p["realizedCount"] + futureCount)
    remainingT = timeGrid[size(timeGrid) - 1] - timeGrid[0]
    return exp(-p["r"] * remainingT) * max(averagePrice - p["K"], 0.0)
}

p = dict(STRING, DOUBLE)
p["r"] = 0.03
p["q"] = 0.0
p["sigma"] = 0.20
p["K"] = 100.0
p["realizedCount"] = 6.0
p["realizedSum"] = 98.0 + 99.0 + 101.0 + 102.0 + 96.0 + 104.0

opt = dict(STRING, ANY)
opt["seed"] = 2026
opt["antithetic"] = true
opt["batchSize"] = 5000
opt["pathMode"] = "full"
seasoned = monteCarlo(gbmEvolveHist, seasonedAsianPayoff, 102.0,
    0..6 / 12.0, 100000, 1, p, opt)
print(seasoned["estimate"])
print(seasoned["stdError"])
此处 initialState=102.0 表示估值日现价,不意味着已知历史 Fixing 的最后一次价格必然等于
102。如果估值日 Fixing 也已确定,应放在历史数据中并从未来观察列表剔除;如果尚未公布,则需要按合同 Fixing
规则确定是否属于未来随机观察。这种归属必须在产品层明确,不能仅靠 timeGrid 的长度推断。
业务提示: 障碍是否已敲入、累计目标收益、雪球是否曾经敲出等也属于历史状态。仅输入当前市场价格而忽略这些状态,会导致存续期估值错误。
| 产品 | 估计值 | 标准误 |
|---|---|---|
| Arithmetic Asian | 5.6090022691 | 0.0190064214 |
| Geometric Asian | 5.4132197153 | 0.0185097102 |
| Seasoned Asian(存续期) | 2.633867593334059 | 0.006737018412437 |
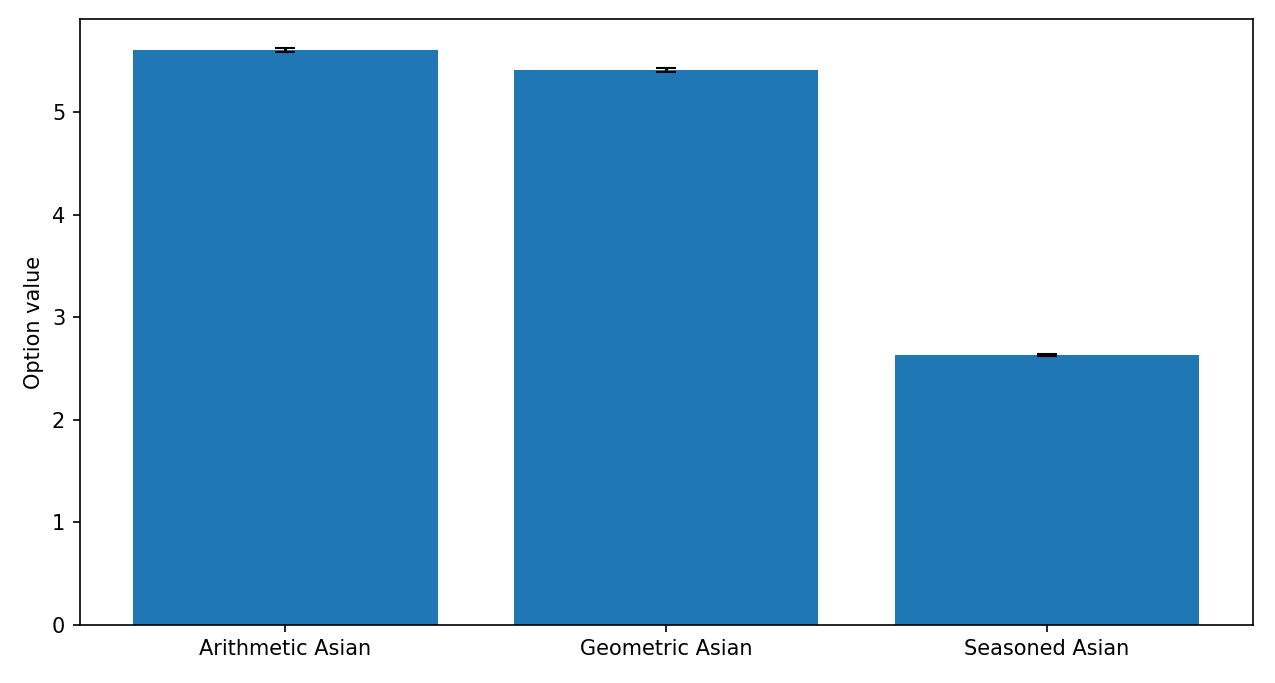
这些输出证明相应案例在 DolphinDB Server 3.00.6.4 及以上版本上可执行。若要进一步证明定价精度,还需使用与同一离散观察日、平均权重和历史 Fixing 约定一致的解析值或独立实现进行交叉验证。
6. 障碍期权与回望期权:沿路径判断事件
6.1 离散障碍与连续障碍不是同一个产品
以向上敲出看涨期权(Up-and-Out Call)为例,给定观察集 O 、障碍 B 和行权价 K,其离散观察收益定义为:
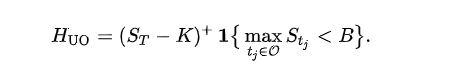
该公式假设触及障碍即敲出、没有 rebate,并且在观察集中包括哪些时点已经明确。与此不同,连续观察障碍要求检查任意连续时间是否触及。仅在离散时间节点上观察,会漏掉两节点之间的触发,因而产生监控偏差。
回望期权(Lookback)则与历史最大值或最小值相关。例如固定行权价回望看涨期权:
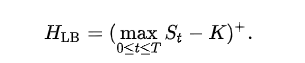
下例定义为离散时间网格上的最大值,不要与连续监测的理论公式混用。
6.2 DLang 案例:同时计算 Up-and-Out 与 Lookback
// 示例 6-1:月度离散障碍敲出 + 月度回望看涨
def gbmEvolve(t, state, dt, noise, p) {
    drift = (p["r"] - p["q"] - 0.5 * p["sigma"] * p["sigma"]) * dt
    return state * exp(drift + p["sigma"] * sqrt(dt) * noise)
}

def barrierLookbackPayoff(paths, timeGrid, p) {
    pathCount = rows(paths[0])
    maxSpot = paths[0][, 0]
    for (i in 1..(size(paths) - 1)) {
        maxSpot = max(maxSpot, paths[i][, 0])
    }
    ST = paths[size(paths) - 1][, 0]
    T = timeGrid[size(timeGrid) - 1] - timeGrid[0]
    df = exp(-p["r"] * T)
    hit = maxSpot >= p["barrier"]
    upOut = df * iif(hit, 0.0, max(ST - p["K"], 0.0))
    lookback = df * max(maxSpot - p["K"], 0.0)
    return matrix(upOut, lookback)
}

p = dict(STRING, DOUBLE)
p["r"] = 0.03
p["q"] = 0.0
p["sigma"] = 0.20
p["K"] = 100.0
p["barrier"] = 120.0
opt = dict(STRING, ANY)
opt["seed"] = 42
opt["antithetic"] = true
opt["batchSize"] = 5000
opt["pathMode"] = "full"
res = monteCarlo(gbmEvolve, barrierLookbackPayoff,
    100.0, 0..12 / 12.0, 100000, 1, p, opt)
print(res["estimate"]) // [离散 Up-and-Out, 离散 Lookback]
print(res["stdError"])
在保持所有其他条件不变的情况下,增加障碍监测频率通常会提高向上障碍被触及的概率,从而降低无 rebate 的 Up-and-Out Call 的价值;但不同网格的单次 MC 估计可能受到采样噪声影响。对回望看涨期权,增加最大值的观察节点通常提高或不降低逐路径 Payoff。比较时最好复用同一随机路径的细网格,再在其上抽取粗网格观察值。
6.3 存续期 Barrier / Lookback 需要保存什么?
-
Barrier:至少需要历史是否触发的布尔状态
barrierHit;若此前已经敲出,后续Payoff应直接遵守敲出后的合同规则。 -
Lookback:至少需要估值日前已经实现的
historicalMax或historicalMin,再与未来模拟极值比较。 -
带窗口障碍:需要明确观察时间窗,窗口外价格不参与判断。
-
带 rebate:需要明确触发时支付还是到期时支付,并按实际时间折现。
7. 多资产期权:相关随机因子与 Exchange 定价
7.1 两资产 GBM 模型
两个资产在风险中性测度下满足:
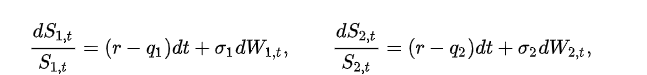
并且 d⟨W₁, W₂⟩ₜ = ρ dt。在 DolphinDB 中,设置 numFactors=2 和
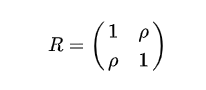
即可要求随机驱动在进入 evolve 前按指定相关结构处理。对于二维非退化相关矩阵,要求
|p|<1;本接口规定输入为正定相关矩阵,相关系数等于 ±1 不符合这一要求。
本文给出两个常见 Payoff:
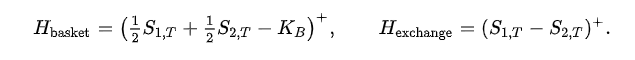
7.2 完整 DLang 示例
// 示例 7-1:两资产 Basket / Exchange
// corr 仅相关化随机因子,不直接修改状态变量
def twoAssetEvolve(t, state, dt, noise, p) {
    s1 = state[, 0] * exp((p["r"] - p["q1"] - 0.5 * p["sig1"] * p["sig1"]) * dt +
                          p["sig1"] * sqrt(dt) * noise[, 0])
    s2 = state[, 1] * exp((p["r"] - p["q2"] - 0.5 * p["sig2"] * p["sig2"]) * dt +
                          p["sig2"] * sqrt(dt) * noise[, 1])
    return matrix(s1, s2)
}

def twoAssetPayoff(terminal, timeGrid, p) {
    s1 = terminal[, 0]
    s2 = terminal[, 1]
    T = timeGrid[size(timeGrid) - 1] - timeGrid[0]
    df = exp(-p["r"] * T)
    basket = df * max(0.5 * s1 + 0.5 * s2 - p["basketK"], 0.0)
    exchange = df * max(s1 - s2, 0.0)
    return matrix(basket, exchange)
}

p = dict(STRING, DOUBLE)
p["S1"] = 100.0
p["S2"] = 95.0
p["r"] = 0.03
p["q1"] = 0.01
p["q2"] = 0.02
p["sig1"] = 0.20
p["sig2"] = 0.25
p["rho"] = 0.40
p["basketK"] = 100.0

R = matrix(1.0 0.0, 0.0 1.0)
R[0, 1] = p["rho"]
R[1, 0] = p["rho"]
opt = dict(STRING, ANY)
opt["seed"] = 42
opt["antithetic"] = true
opt["batchSize"] = 10000
opt["pathMode"] = "terminal"
opt["corr"] = R

res = monteCarlo(twoAssetEvolve, twoAssetPayoff,
    [p["S1"], p["S2"]], 0..12 / 12.0, 200000, 2, p, opt)
print(res["estimate"]) // [Basket, Exchange]
print(res["stdError"])
7.3 Exchange Option 的 Margrabe 解析校验
无附加现金支付和行权成本、到期交换一单位资产 2 为一单位资产 1 的欧式交换期权,在上述模型假设下有 Margrabe 解析公式:
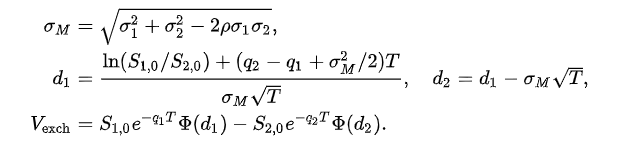
// 续示例 7-1:独立解析基准
T = 1.0
sigM = sqrt(p["sig1"] * p["sig1"] + p["sig2"] * p["sig2"] -
            2.0 * p["rho"] * p["sig1"] * p["sig2"])
d1 = (log(p["S1"] / p["S2"]) +
      (p["q2"] - p["q1"] + 0.5 * sigM * sigM) * T) / (sigM * sqrt(T))
d2 = d1 - sigM * sqrt(T)
reference = p["S1"] * exp(-p["q1"] * T) * cdfNormal(0.0, 1.0, d1) -
            p["S2"] * exp(-p["q2"] * T) * cdfNormal(0.0, 1.0, d2)
print(reference)
print(res["estimate"][1] - reference)
assert 1, abs(res["estimate"][1] - reference) <= 4.0 * res["stdError"][1]
从例子中抽象出的三个原则:
initialState 决定状态数;numFactors 决定独立高斯驱动的输入维数;corr
只规定驱动的相关结构,并不代替 evolve 中的波动率加载矩阵。对于多资产 GBM,可进一步扩展为
Spread、Rainbow、Best-of、Worst-of 等,但实际金融合约还应指定权重、标的币种、股息及结算机制。
Quanto 提醒: 跨币种定价要区分支付币种、汇率风险与定价测度。固定换汇比率的 Quanto 在相关的外汇风险存在时,一般需要 Quanto 漂移修正或相应联合测度处理;不能简单以本币股票 GBM 路径乘固定 FX 再声称是完整 Quanto 定价。
| 产品 | Monte Carlo 估计值 | 标准误 | 解析/参考值 | 差异 |
|---|---|---|---|---|
| Basket Option | 6.7759933660 | 0.0208456205 | — | — |
| Exchange Option | 12.7991295697 | 0.0208079287 | 12.7831298602(Margrabe) | +0.0159997095 |
Exchange 的模拟值与 Margrabe 解析值只相差约 0.0160,约为 0.77
个标准误,说明本组参数下的两资产相关 GBM 实现与解析基准具有良好一致性。
8. Heston 随机波动率模型:多状态与双因子驱动
8.1 为什么从 GBM 扩展到 Heston?
GBM 假设波动率为常数。实际期权市场的隐含波动率通常随期限和行权价变化,单一常数波动率难以同时解释完整波动率曲面。Heston 模型允许瞬时方差本身随时间随机变化:
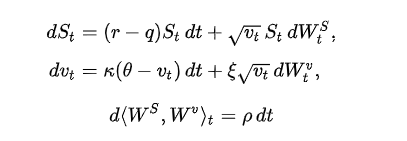
其中 vt 是瞬时方差,k 为均值回复速度,θ 为长期方差水平,ξ 为方差波动率(vol-of-vol),ρ 为价格与方差驱动相关性。此模型的状态维度为 2、随机因子数为 2。
8.2 数值离散:先明确采用什么方案
CIR 型方差过程在真实连续时间中非负,但朴素 Euler 更新可能得到负方差。下面使用全截断思路(Full Truncation Euler):先把当前负方差按零处理,更新后的方差再截断到零;价格使用对数形式的离散更新。
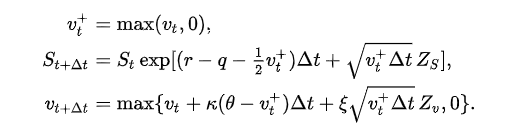
这是一种数值近似,不等于 Heston 过程的精确离散。若用于模型参数校准、希腊字母或低容差定价,应进一步评估时间步离散偏差,并考虑更精细的方差模拟方法。
8.3 完整 DLang 示例
// 示例 8-1:Heston 欧式看涨期权
// state 两列:[股价 S, 瞬时方差 v]
// noise 两列:已相关化的两个标准正态驱动
def hestonEvolve(t, state, dt, noise, p) {
    S = state[, 0]
    v = state[, 1]
    vPos = max(v, 0.0)
    nextS = S * exp((p["r"] - p["q"] - 0.5 * vPos) * dt +
                    sqrt(vPos * dt) * noise[, 0])
    nextV = max(v + p["kappa"] * (p["theta"] - vPos) * dt +
                p["xi"] * sqrt(vPos * dt) * noise[, 1], 0.0)
    return matrix(nextS, nextV)
}

def hestonPayoff(terminalState, timeGrid, p) {
    T = timeGrid[size(timeGrid) - 1] - timeGrid[0]
    ST = terminalState[, 0]
    vT = terminalState[, 1]
    callPV = exp(-p["r"] * T) * max(ST - p["K"], 0.0)
    // 第二列是 E[vT],不是期权现金流,不能再折现
    return matrix(callPV, vT)
}

p = dict(STRING, DOUBLE)
p["r"] = 0.03
p["q"] = 0.0
p["K"] = 100.0
p["kappa"] = 2.0
p["theta"] = 0.04
p["xi"] = 0.50
p["rho"] = -0.70

R = matrix(1.0 0.0, 0.0 1.0)
R[0, 1] = p["rho"]
R[1, 0] = p["rho"]
opt = dict(STRING, ANY)
opt["seed"] = 42
opt["batchSize"] = 10000
opt["antithetic"] = true
opt["pathMode"] = "terminal"
opt["corr"] = R

res = monteCarlo(hestonEvolve, hestonPayoff,
    100.0 0.04, 0..252 / 252.0, 300000, 2, p, opt)
print(res["estimate"])  // [Heston Call 价格, 到期方差的期望]
print(res["stdError"])
本例以单位股价和单位期权支付为口径,选用 v0= 0.04 、θ = 0.04 ,对应约 20% 初始和长期波动率。ρ = -0.7 允许模型反映价格下行与方差上升的统计联系。
9. 结构化产品:以简化雪球为例构造状态机
9.1 为什么雪球不能仅用到期价格判断?
雪球(Snowball)类结构通常同时依赖于敲入、敲出、票息、提前终止和历史状态。典型规则包含:
-
敲出观察:只在合同规定的敲出观察日判断是否达到敲出价格,命中后通常提前终止。
-
敲入观察:按合同约定的日频或连续监测,记录整个存续期是否曾发生敲入。
-
到期判断:如没有敲出,则结合是否敲入及到期表现计算兑付。
-
现金流折现:若在第 T 日敲出,需按 T 对兑付额折现,不能一律使用 T 折现。
真实雪球的条款因产品而异:敲出观察日可能存在锁定期,敲出水平可能逐次下调,票息和亏损承担方式也可能不同。下面是明确约定的教学型简化结构,不是任意雪球产品的通用定价器。
9.2 本章示例的简化产品条款
| 条款 | 设定 |
|---|---|
| 名义本金 | N0 = 100 |
| 初始参考价格 | Sref = 100 |
| 期限 | 1 年,按 252 个等长风险中性时间步模拟 |
| 敲出水平 | 1.03Sref |
| 敲入水平 | 0.80Sref |
| 敲出观察日 | 第 63、126、189、252 步(约每季度一次) |
| 敲入观察日 | 每个离散模拟日,包括到期日 |
| 敲出兑付 | N0(1+ct),在首次敲出日 t 支付 |
| 未敲出、未敲入 | 到期支付 N0(1+ct) |
| 未敲出、曾敲入 | 到期支付 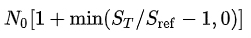 ,不另付票息 |
| 年化简单票息 | c = 12% |
| 分红与贴现 | q = 0,连续复利折现,r = 3% |
这是一笔与向投资者支付的正向兑付现值有关的示例。它不包含发行费用、对冲成本、融资利差、信用风险、担保方式、特殊结算规则,也不等同于发行方完整公允价值或发行价。
9.3 状态机与 Payoff
将每条路径的产品状态表示为:
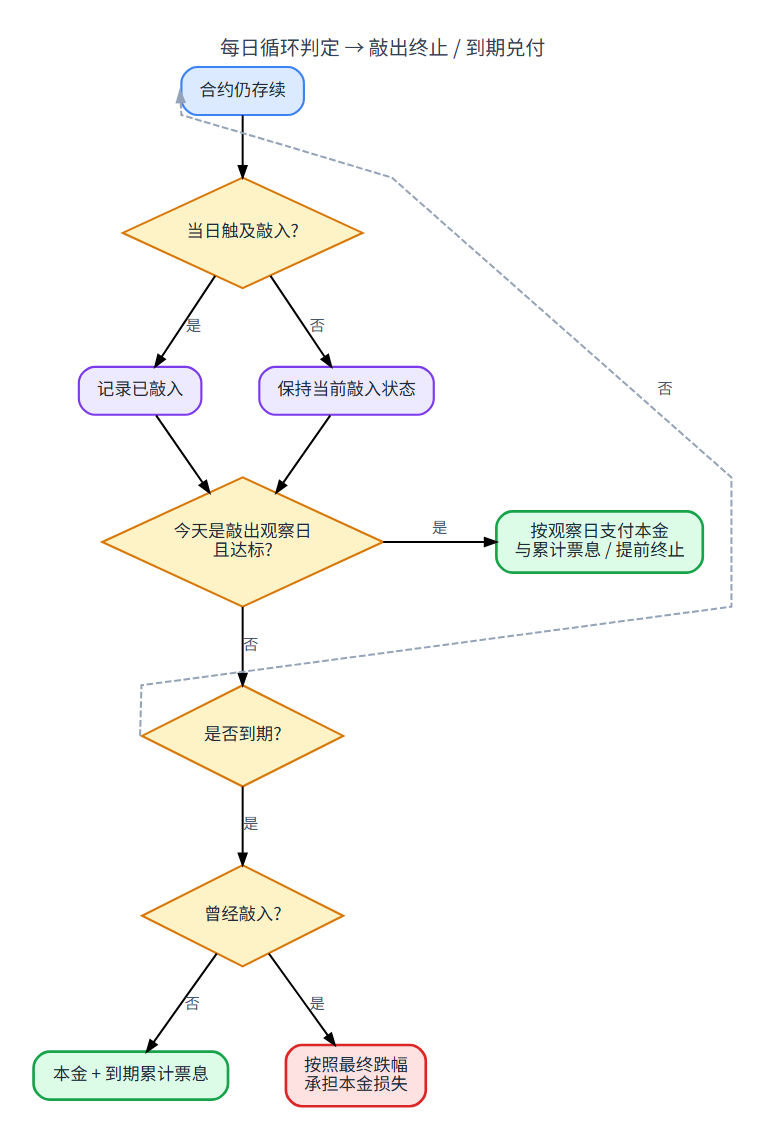
关键顺序: 首次敲出后该路径不再产生未来现金流;敲入历史在敲出前持续记录。若同一天同时发生“敲出”和“敲入”触发,需要用合同明确判定顺序。本例的两个阈值互不冲突(敲入 80、敲出 103),不会产生同一价格同时触发的歧义。
9.4 DLang 示例
// 示例 9-1:教学用简化雪球,离散日敲入、季度敲出
// 依照第 9.2 节条款,不是生产合约模板
def gbmEvolve(t, state, dt, noise, p) {
    drift = (p["r"] - p["q"] - 0.5 * p["sigma"] * p["sigma"]) * dt
    return state * exp(drift + p["sigma"] * sqrt(dt) * noise)
}

def snowballPayoff(paths, timeGrid, p) {
    n = rows(paths[0])
    alive = take(true, n)        // 是否仍未敲出
    knockedIn = take(false, n)   // 是否曾触及敲入线
    pv = take(0.0, n)            // 路径现金流现值累计
    last = size(paths) - 1

    for (i in 1..last) {
        spot = paths[i][, 0]
        t = timeGrid[i] - timeGrid[0]
        // 每个模拟日观察敲入,敲出后的状态不影响后续给付
        knockedIn = knockedIn || (alive && (spot <= p["kiLevel"]))

        // 本例第 63、126、189、252 个模拟日为敲出观察日
        if (i == 63 || i == 126 || i == 189 || i == 252) {
            newKO = alive && (spot >= p["koLevel"])
            redemption = p["notional"] * (1.0 + p["coupon"] * t)
            pv += iif(newKO, exp(-p["r"] * t) * redemption, 0.0)
            alive = alive && (!newKO)
        }
    }

    ST = paths[last][, 0]
    T = timeGrid[last] - timeGrid[0]
    noKnockInPay = p["notional"] * (1.0 + p["coupon"] * T)
    knockInPay = p["notional"] *
                 (1.0 + min(ST / p["referenceSpot"] - 1.0, 0.0))
    maturityPay = iif(knockedIn, knockInPay, noKnockInPay)
    // 仅未提前敲出的路径领取到期现金流
    pv += iif(alive, exp(-p["r"] * T) * maturityPay, 0.0)
    return pv
}

p = dict(STRING, DOUBLE)
p["r"] = 0.03
p["q"] = 0.0
p["sigma"] = 0.20
p["notional"] = 100.0
p["referenceSpot"] = 100.0
p["koLevel"] = 103.0
p["kiLevel"] = 80.0
p["coupon"] = 0.12

opt = dict(STRING, ANY)
opt["seed"] = 42
opt["antithetic"] = true
opt["batchSize"] = 5000
opt["pathMode"] = "full"

res = monteCarlo(gbmEvolve, snowballPayoff,
    100.0, 0..252 / 252.0, 100000, 1, p, opt)
print(res["estimate"]) // 按本章规则计算的投资者兑付现值
print(res["stdError"])与只检查全路径最高价并统一在到期折现的简化写法相比,这个例子显式区分了敲出观察日、第一次敲出、敲入历史、支付日以及到期状态,更接近真实结构化产品的工程建模方式。
如何加入存续期状态?
当估值日不是产品起始日时,至少需把以下字段作为 params 的一部分输入:当前参考价格、历史敲入状态、已过观察日、是否已敲出及已结算现金流、剩余敲出观察日与优惠条款等。若产品已经敲出,应依据真实合同和结算状态直接处理,不应再作为一个仍存续的普通雪球进行未来随机路径估值。
生产化前需要扩展的内容
现实条款通常基于真实交易日历,日期与年化时间并非简单的 i/252。生产实现须增加真实观察日与结算日映射、日计数方法、股息处理、曲线折现、实际现金流记录及不同合同条款的单元测试。连续障碍还需连续监控修正或相应数值模型。对于雪球的票息率反求,可在模型和条款均固定的前提下,将票息 c 作为外层目标变量,重复估值并使用求根算法;这不是本次通用 Monte Carlo 函数自带的功能。
10. 数值验证:准确性、收敛性与方差缩减
10.1 数值验证应该分为三层
金融定价数值方法不仅要“跑出一个数字”,还要证明这一数字在给定假设下具有可信的统计含义。建议采用三层验证体系:
| 层次 | 验证对象 | 方法 | 典型案例 |
|---|---|---|---|
| 第一层:解析基准 | 模型和 Payoff 是否一致 | BS、Digital、几何 Asian、Margrabe | 欧洲 Vanilla、Exchange |
| 第二层:独立实现 | 非闭式或合同敏感产品 | NumPy/SciPy、QuantLib、PriceLib 或独立高精度算法 | 算术 Asian、Barrier、Heston、Basket |
| 第三层:数值鲁棒性 | 统计误差、离散偏差、边界状态 | 路径数收敛、时间步收敛、极限情形、反例测试 | Heston、雪球、存续期 Asian |
注意:把一套 Monte Carlo 与另一套 Monte Carlo 比较,只能增加交叉验证证据。如果两套实现采用相同的错误现金流或错误观察规则,仍可能一致。因此,产品规则的独立校验与数值算法的独立校验缺一不可。
10.2 随机抽样误差与离散化偏差要分别衡量
对于模拟得到的价格估计,可以在概念上把误差分为:
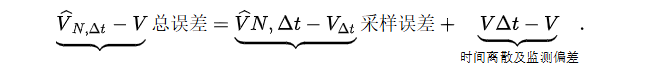
对 GBM 的欧式期权,使用指数精确离散时,不存在来自 GBM 状态更新的时间离散偏差;对 Euler Heston 和离散观察
Barrier,则必须分别研究步长偏差。降低 stdError 不能替代减少时间离散偏差。
10.3 实测结果的验证解读
将本次实测结果与第 4、5、7、8、9 章对照,可以得到几个清晰结论:
-
函数接口与案例代码可运行:11 个案例全部执行成功。
-
欧式与 Exchange 的解析校验成立:Call / Put 与 Black–Scholes,Exchange 与 Margrabe 都具备独立解析基准。
-
Digital 更适合作为“统计敏感性提示案例”:从本次结果看,Digital 的绝对误差虽小,但相对于标准误偏大,说明不连续 Payoff 对路径数更加敏感。
-
路径依赖与复杂产品已跑通,但验证等级不同:Asian、Barrier、Lookback、Basket、Heston 与雪球的“运行成功”不等于“全部完成独立数值校验”,需要继续结合收敛实验和外部基准。
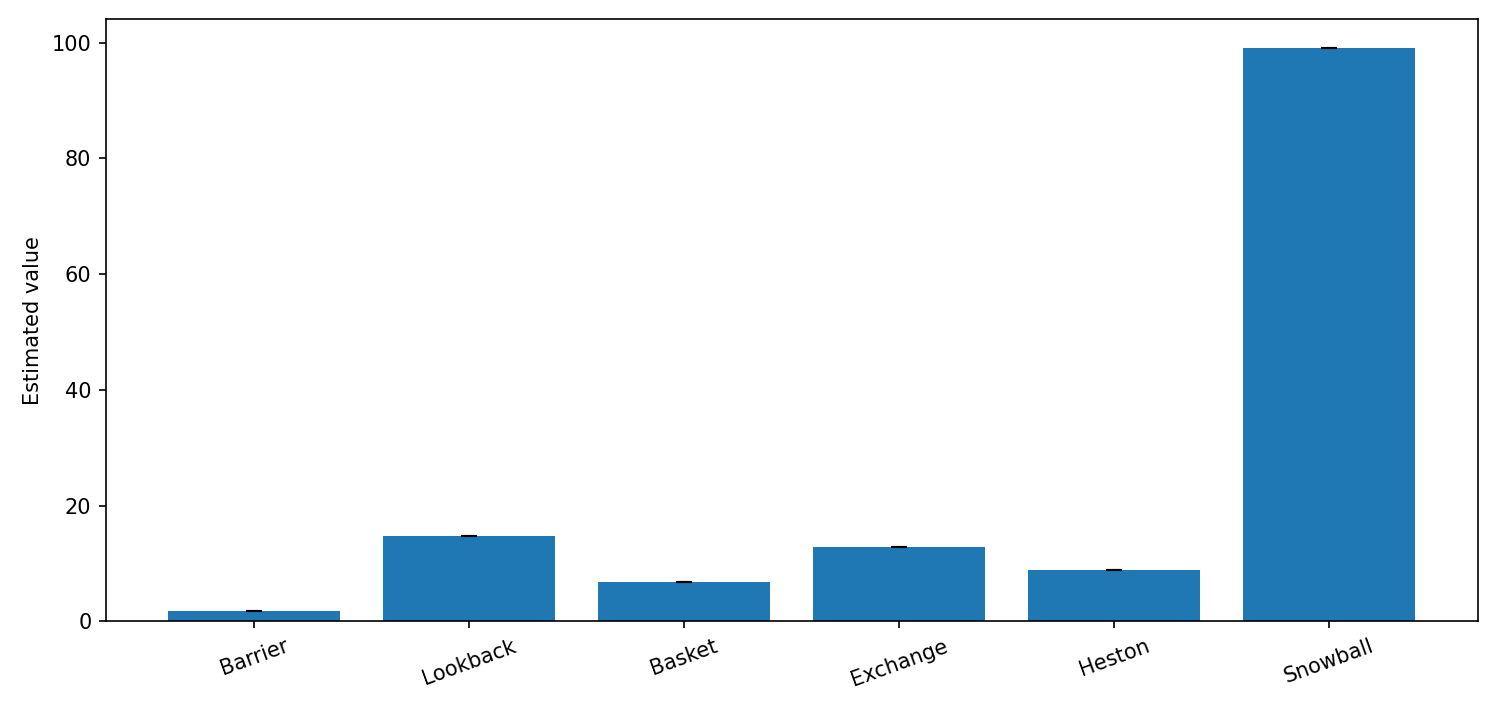
下图汇总了本次实测各案例的标准误。它有助于比较不同产品在相近路径规模下的统计不确定性。
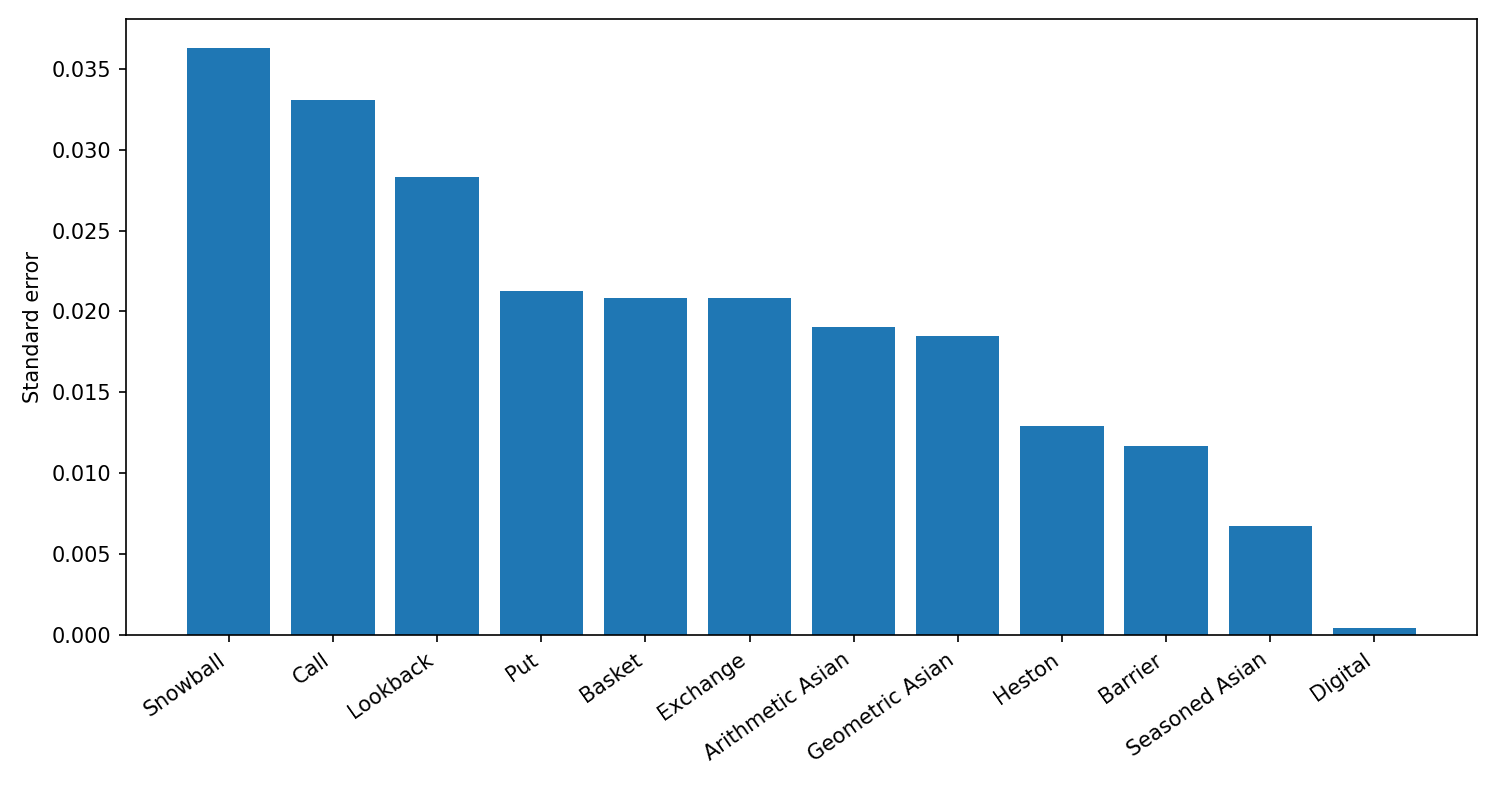
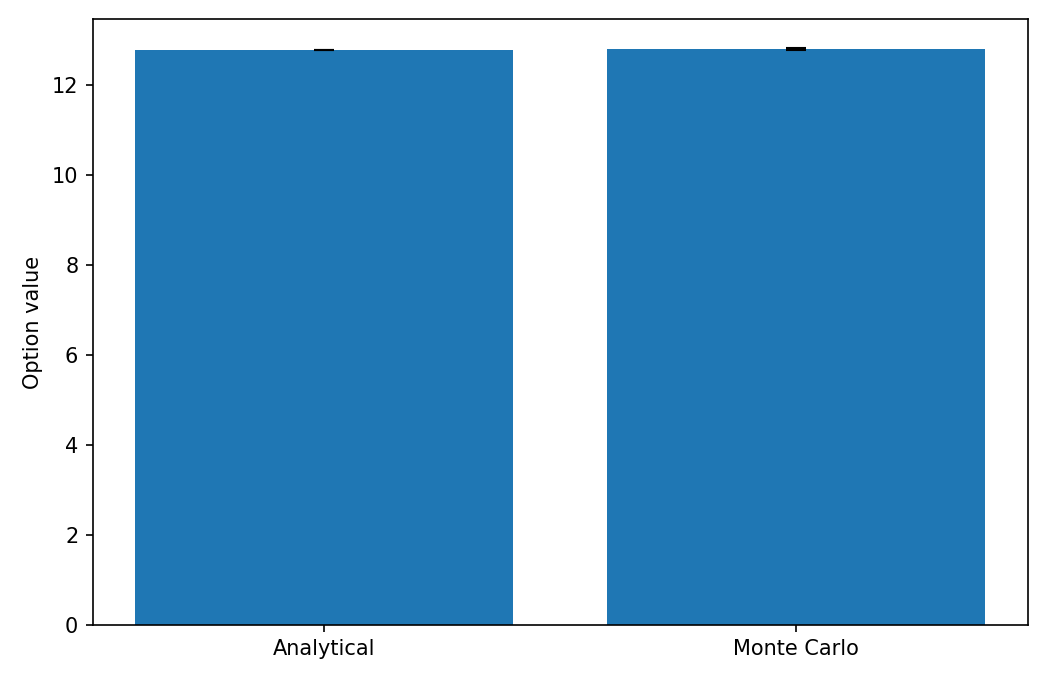
从图 10-1 可以看到,雪球、Call、Lookback 的标准误相对更高;Digital 最低,这并不意味着它“最好算”,而是说明在当前设定下其样本方差较小。是否足够准确,还要看与理论值或高精度参考值的偏差。
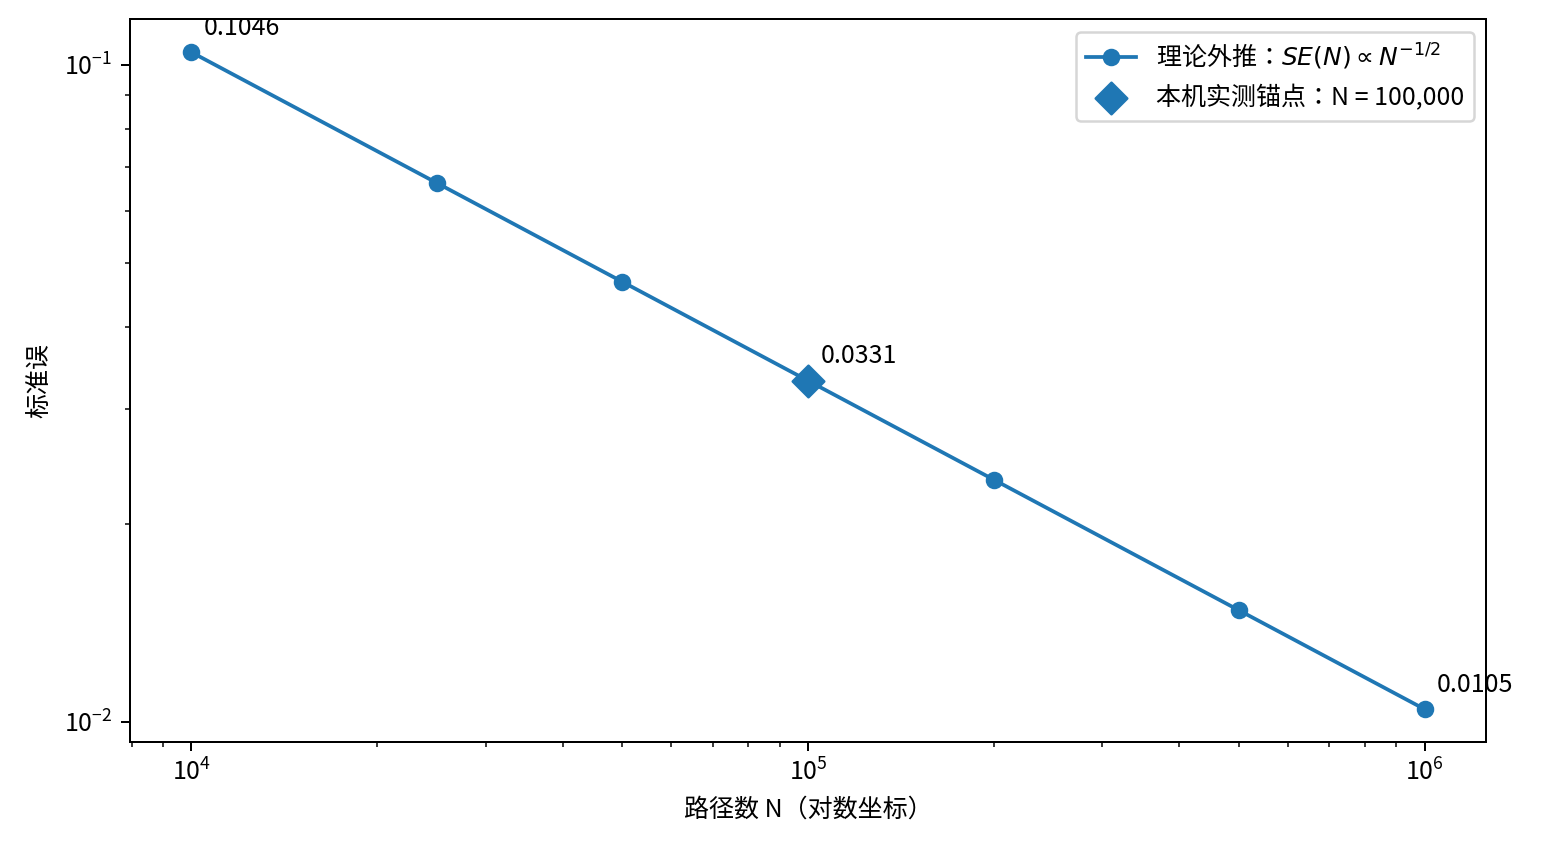
收敛性参考图:如何阅读,哪些不是实测
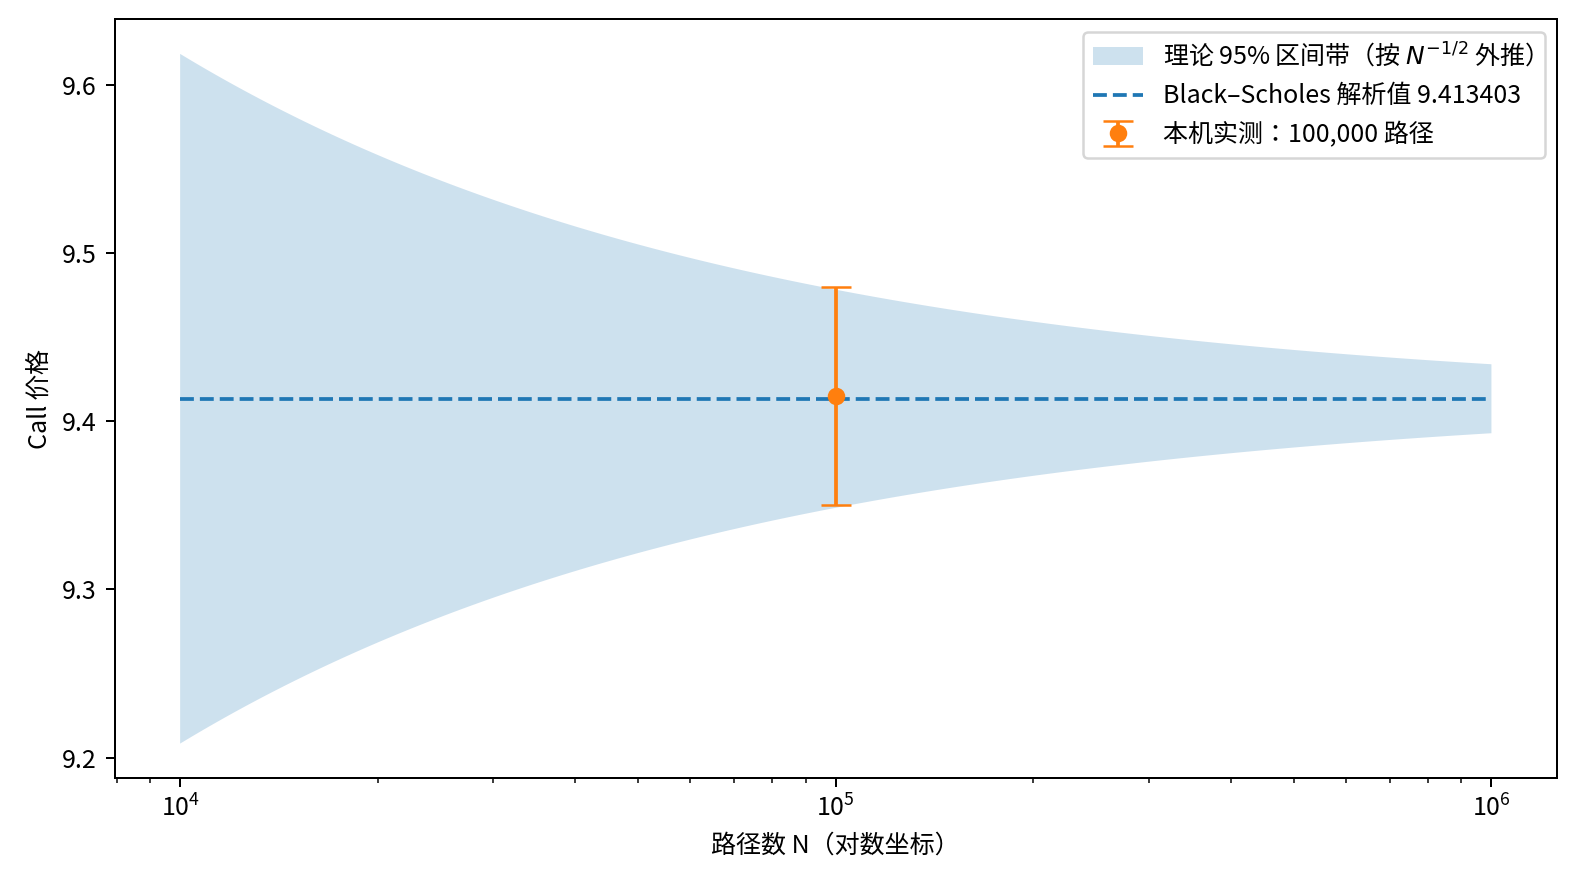
当前本机结果只提供了一个路径规模下的标准误,因此不能把多路径曲线标记为实测收敛曲线。下面两图以欧式 Call 的本机实测标准误 0.0330891(100,000 路径)为锚点,按独立同分布 Monte Carlo 的理论关系 SE(N) ≈ SE(N₀) × sqrt(N₀/N) 计算其他路径数下的参考值。这些曲线用于制定实验预期,不是 DolphinDB 在各路径数下的实测表现,也不包含运行时间数据。
10.4 统一跨引擎准确性与模式等价测试
本节测试对 DolphinDB、NumPy、QuantLib、PriceLib 的 standard 与 log 两种写法进行了统一检查。
测试口径: 100,000 条路径 × 126 个时间步,batchSize=10,000,启用对偶变量法;预热 1 次、性能计时 7 次、独立准确性重复 3 次。非解析场景采用 500,000 路径的独立 NumPy Monte Carlo 作为参考,并把参考估计的标准误纳入合并标准误。
| 检查项 | 结果 | 说明 |
|---|---|---|
| 候选测试项 | 48 | 6 个场景 × 4 个引擎 × 2 种写法 |
| 获得实际计时 | 45 | 包含 1 项存在 Heston 离散方案差异的 QuantLib 计时 |
| 同口径准确性检查 | 44/44 通过 | 使用解析值或独立高路径 MC,并按 4 倍合并标准误判定 |
standard/log 等价性检查 |
22/22 通过 | 比较估值、方差与标准误 |
| 已声明不支持 | 3 | QuantLib Heston log;PriceLib 两种 Basket 写法 |
| 真实执行或检查失败 | 0 | 不将不支持项或约定不一致项伪装为通过 |
下面汇总 DolphinDB 在三次独立准确性运行中的平均估值,与对应参考值的对照。合并标准误为 DolphinDB 平均估值的标准误与参考值标准误的平方和开根号;解析基准的参考标准误为 0。表中“误差/合并 SE”使用绝对误差,全部低于验收阈值 4。
| 场景 | DolphinDB 平均估值 | 参考值 | 参考来源 | 误差(DDB−参考) | 合并标准误 | 绝对误差 / 合并 SE |
|---|---|---|---|---|---|---|
| European Call | 9.389267 | 9.413403 | Black–Scholes 解析值 | −0.024137 | 0.019239 | 1.25 |
| 几何 Asian | 5.111159 | 5.119650 | 几何 Asian 解析值 | −0.008491 | 0.010050 | 0.84 |
| 算术 Asian | 5.307309 | 5.311404 | 独立高路径 NumPy MC | −0.004094 | 0.013112 | 0.31 |
| Heston Call | 8.983339 | 8.989376 | 独立高路径 NumPy MC | −0.006037 | 0.016456 | 0.37 |
| 离散 Up-and-Out | 1.368675 | 1.362833 | 独立高路径 NumPy MC | +0.005841 | 0.007447 | 0.78 |
| 两资产 Basket | 6.740214 | 6.757699 | 独立高路径 NumPy MC | −0.017485 | 0.021509 | 0.81 |
以上结果支持的结论是:本轮指定参数、采样配置与合约约定下,所有纳入同口径门禁的测试项均通过。
10.5 对偶变量(Antithetic Variates)
普通 Monte Carlo 使用独立随机向量 Zi。对偶变量法成对使用 Zi 和 -Zi,对每对收益取均值:
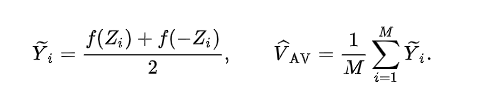
如果两条配对收益之间存在负相关,就可能降低估计方差。但对于不连续障碍收益,效果未必显著。标准误必须以 M 个配对平均值作为统计单元估计,不能把 2M 条配对路径错误地视为 2M 个独立收益。
所附历史报告中,在 numPaths=50000 的测试条件下:
| DolphinDB 场景 | antithetic=false 标准误 | antithetic=true 标准误 | 原记录的标准误下降 |
|---|---|---|---|
| 欧式 Call | 0.062888 | 0.047171 | 约 25.0% |
| 欧式 Put | 0.041822 | 0.030265 | 约 27.6% |
| Exchange | 0.069611 | 0.041682 | 约 40.1% |
| Heston Call | 0.046810 | 0.031718 | 约 32.2% |
| 离散 Up-and-Out | 0.015203 | 0.014100 | 约 7.3% |
这些改善幅度属于给定样本和模型下的历史观察结果。对偶变量是精度改善方法,不等价于降低每条路径的计算耗时。
11. 性能测试、工程实践与方法选择
11.1 性能问题不能只看“运行了多少路径”
Monte Carlo 的主要计算成本往往来自随机数生成、每个时间步的状态更新、路径信息保存及产品 Payoff 计算。对于路径依赖产品,在路径数 N、时间步数 M、状态维度 d 均增长时,需要注意:
-
随机数规模通常与 N × M ×numFactors 相关。
-
状态推进通常至少与 N × M × d 相关,实际复杂度取决于模型。
-
full路径在一个批次中保存的状态量约与batchSize × (M+1) × d成正比;terminal可显著降低路径状态的存储需求。 -
returnPaths=true则可能要求最终返回所有路径、内存量与总路径数,而不仅是单批大小相关。 -
多资产 Heston、带路径状态机的雪球等模型,Payoff 的运算成本与纯欧式终值计算不可直接等同。
因此,比较 MC 性能至少要说明:路径数、时间步数、状态和因子数、合同 Payoff、采样技术、批次、并行方式、硬件环境及计时边界。
11.2 性能测试
本节对 DolphinDB、NumPy、QuantLib、PriceLib 的 standard 与 log 两种写法进行了统一性能测试。
统一配置: 100,000 条路径 × 126 个时间步,batchSize=10,000,单 worker,启用对偶变量法;预热 1 次、正式计时 7 次,主表取端到端 wall time 的中位数。连接、模块定义与 worker 池创建不计时;DolphinDB 主表计时包含 SDK 往返,其他库计时包含各自适配器调用、路径生成、Payoff、统计汇总及批次调度。
11.2.1 端到端耗时对比
单位为毫秒,越低越好。standard 与 log 是同一引擎下的两种状态表示/实现方式,不代表不同产品功能。
| 场景 | DDB 标准 | DDB log | NumPy 标准 | NumPy log | QuantLib 标准 | QuantLib log | PriceLib 标准 | PriceLib log |
|---|---|---|---|---|---|---|---|---|
| European Call | 98.0 | 38.0 | 144.9 | 86.1 | 2447.2 | 571.2 | 209.5 | 152.6 |
| 几何 Asian | 241.0 | 80.4 | 223.4 | 94.3 | 10845.0 | 9438.8 | 249.2 | 142.4 |
| 算术 Asian | 139.1 | 208.0 | 154.4 | 183.1 | 10704.0 | 11320.1 | 199.1 | 202.8 |
| Heston Call | 344.8 | 283.2 | 316.3 | 256.4 | 2859.3† | N/A | 420.8 | 362.3 |
| 离散 Up-and-Out | 124.4 | 71.5 | 155.4 | 123.9 | 9762.1 | 10380.7 | 198.0 | 147.6 |
| 两资产 Basket | 315.9 | 180.6 | 310.4 | 192.1 | 5655.3 | 1429.5 | N/A | N/A |
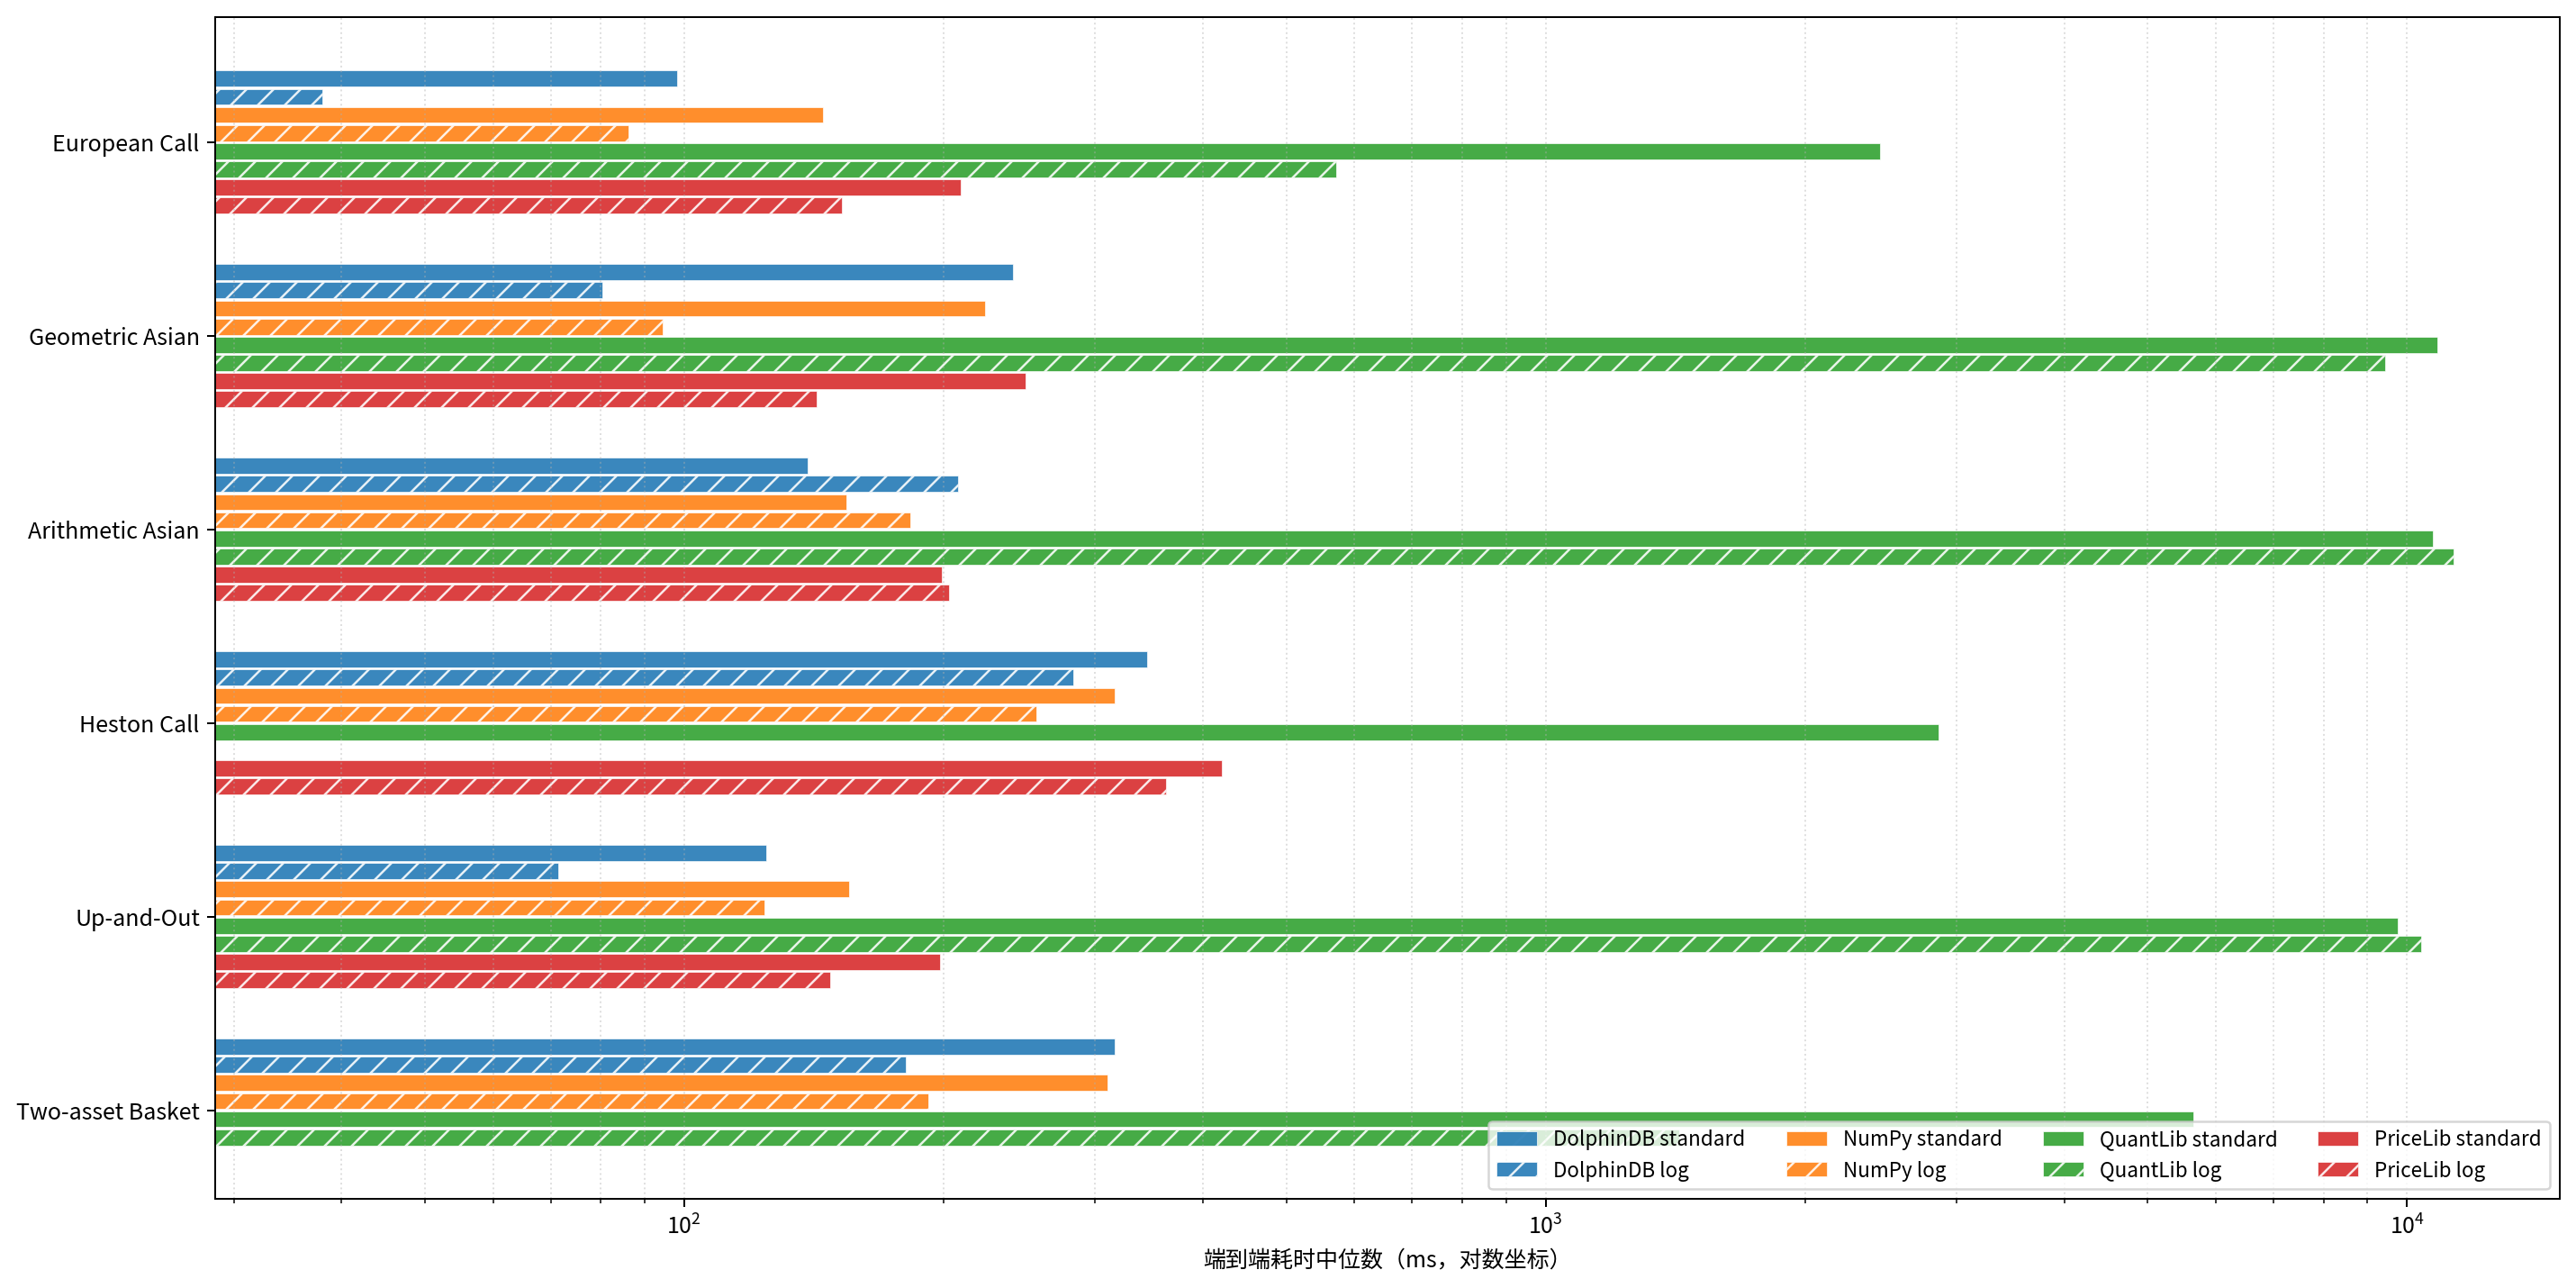
QuantLib Heston 标准写法采用原生 FullTruncation 方差离散方式,与其他实现的 projected-variance Euler 方案不同。该项保留计时展示,但不参与同离散方案的准确性门禁或排名。N/A 表示对应接口明确不支持:QuantLib 没有此处所需的 Heston log-state 路径过程;PriceLib 1.3 路径接口不支持本测试中的相关多资产 GBM Basket。
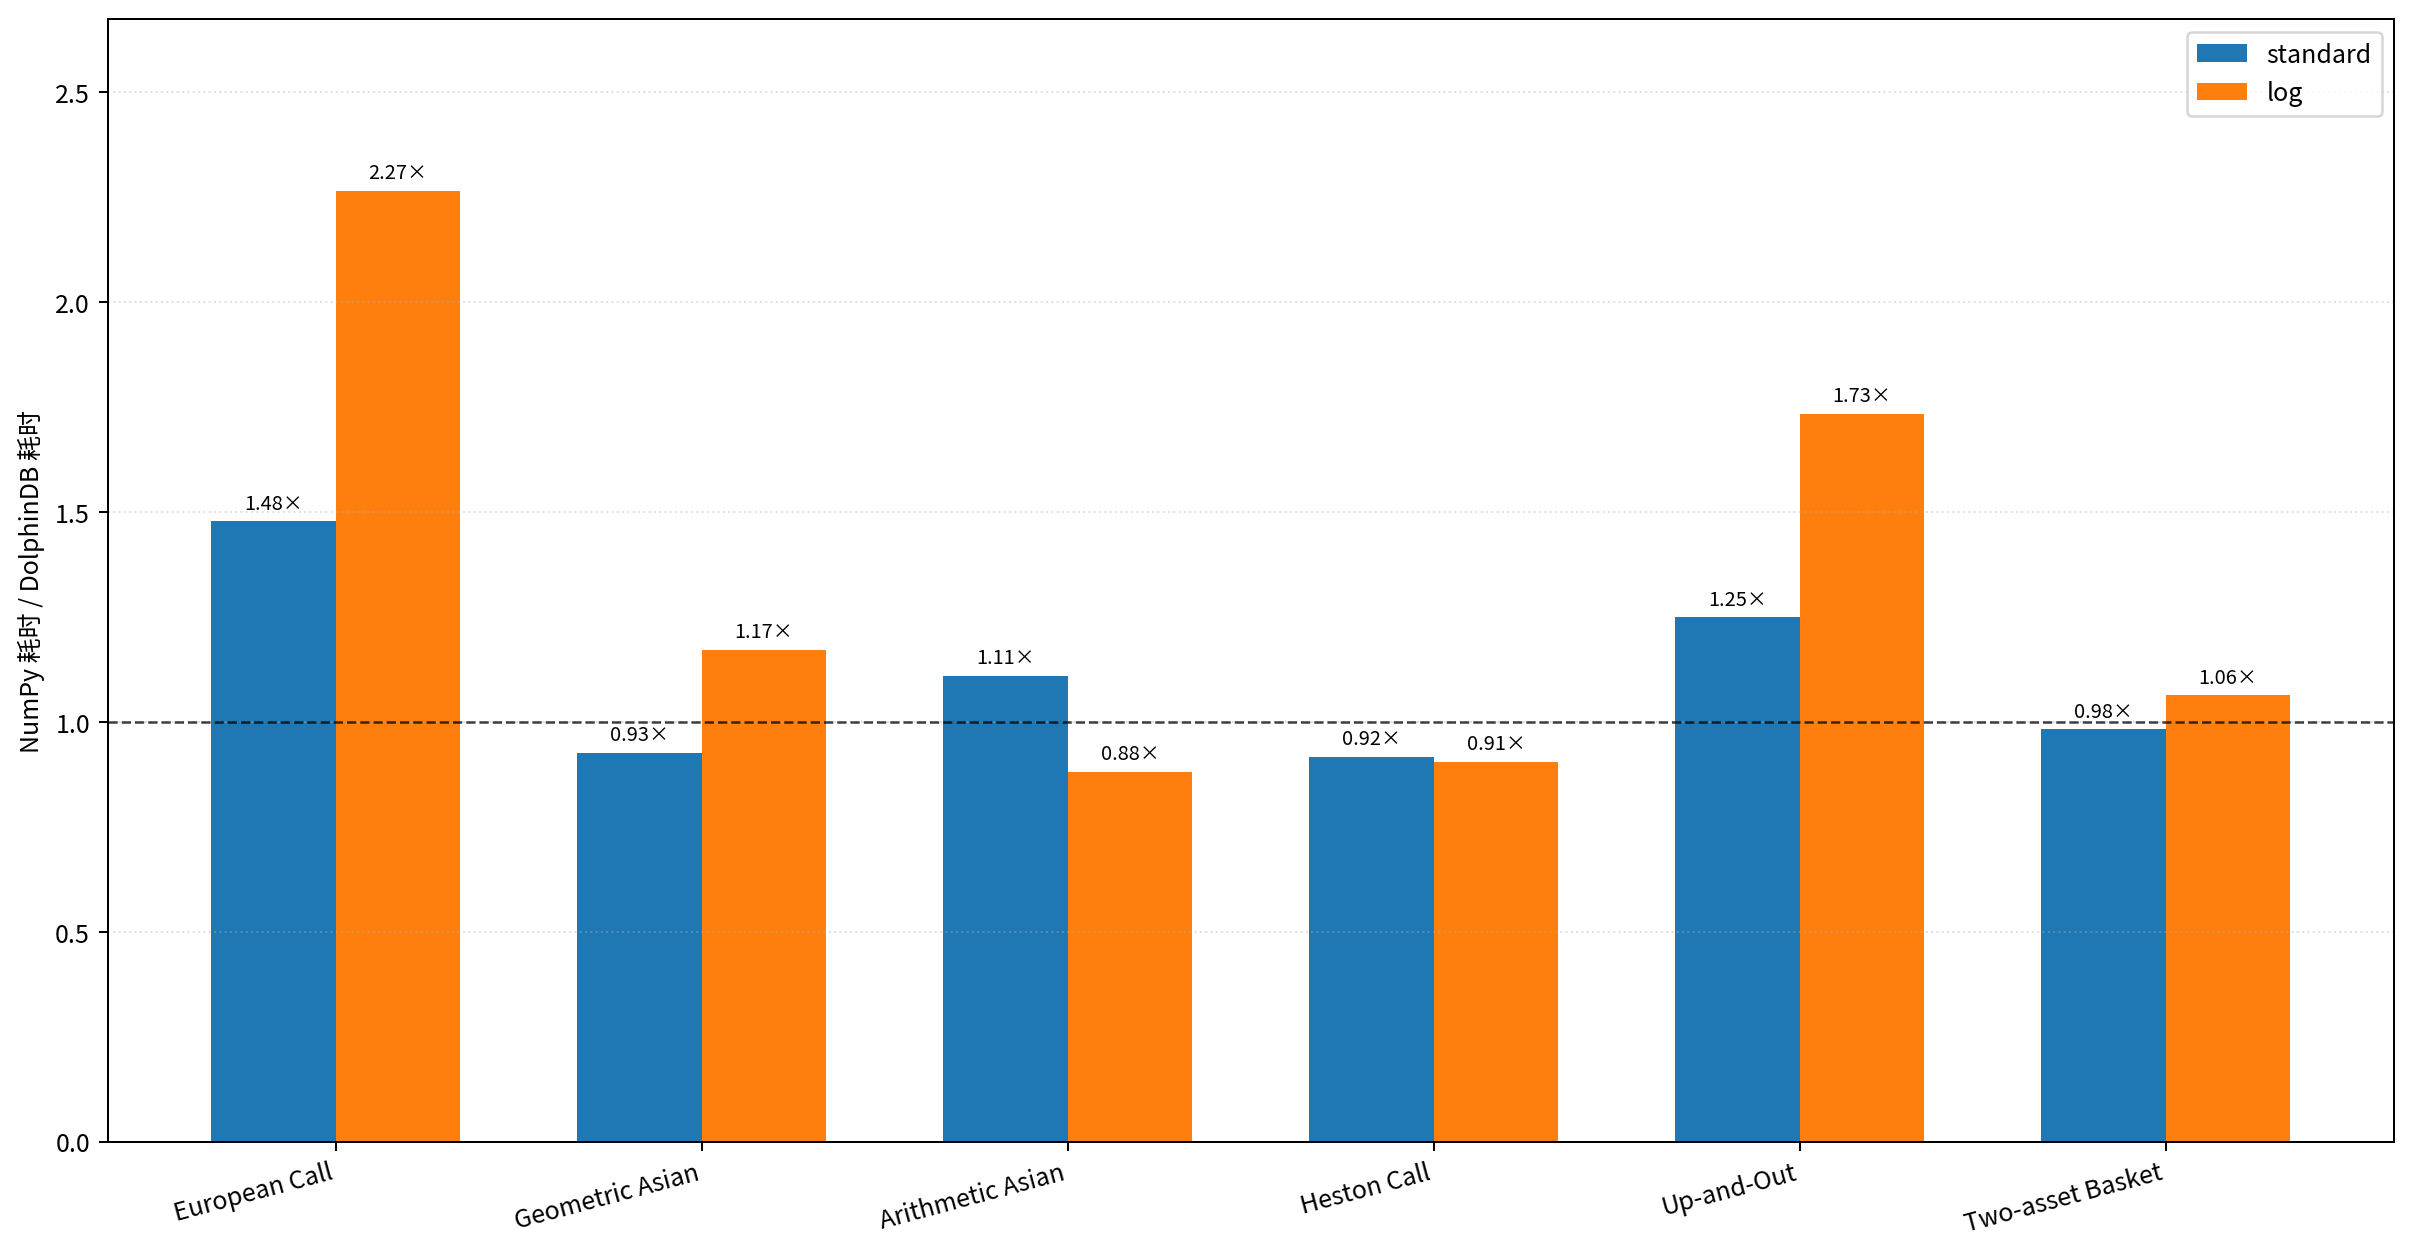
该测试基于DolphinDB Server 3.00.6.4,在单线程、10 万路径、126 个时间步的条件下,DolphinDB 通用 Monte Carlo 框架与 NumPy 向量化实现具有相当的计算性能,并在部分场景中取得一定的速度优势。其中,经过计算表达式优化的 European Call 和 Up-and-Out 场景表现尤为突出。
需要指出的是,单项 Monte Carlo 任务的执行速度并非衡量金融数值计算平台价值的唯一标准。相比于单纯使用数值计算库实现独立算法,DolphinDB 通用 Monte Carlo 框架的价值还体现在以下方面:
统一数值计算抽象。 通过 evolve 和 payoff 回调分离随机过程与产品现金流逻辑,将随机数生成、相关因子处理、批量路径模拟、方差缩减及统计估计封装为可复用的基础能力,降低不同产品之间的重复开发成本。
灵活扩展复杂金融产品。 支持用户自定义状态变量、随机因子及路径依赖收益,便于研究和实现 Asian、Barrier、Basket、Heston 及结构化产品等不同模型和现金流规则。
数据与计算协同。 依托 DolphinDB 的时序数据库、批量分析及流计算能力,通用 Monte Carlo 可以作为金融数据处理与估值工作流中的数值计算组件,在具备相应系统集成的条件下,减少跨系统数据传递和应用开发工作。
面向生产环境的工程复用。 用户定义的数值模型能够与 DolphinDB 的服务端计算、数据管理、任务管理及权限体系结合,为批量估值、风险情景分析和定制产品研究提供可扩展的技术基础。
因此,DolphinDB 的优势不应仅以单一算法场景下的加速倍数衡量,更应从数值计算效率、模型开发成本、业务集成复杂度和金融工程系统的整体可维护性进行综合评价。
本次性能测试证明了其在所测场景中的计算效率;多任务并发、分布式扩展和端到端业务链路的具体收益,仍需通过独立实验进一步验证。
11.3 DolphinDB 实战优化建议
-
优先使用批次矩阵向量化。 回调参数已经按
batchPathCount × stateDim整批传入,应尽量采用矩阵列运算,而非逐路径循环进行标量计算。 -
按 Payoff 选择路径模式。 Vanilla、Digital、纯终值 Basket 选择
terminal;Asian、Barrier、Lookback 和多数带观察日的雪球选择full。不要为追求短代码而无条件保存完整路径。 -
历史事件归入业务状态。 对 Asian 使用历史累计值和计数,对 Lookback 使用历史最大/最小值,对 Barrier 使用历史命中标志,对雪球使用历史敲入/敲出状态。这样比从合约起始日重新模拟更符合存续期估值逻辑。
-
固定种子辅助测试,但不要误以为跨环境完全一致。 所附函数说明规定:在输入、种子、批次大小、并行设置、DolphinDB 版本和环境一致时可复现;改变这些条件后,随机序列及最终估计的低位差异可能变化。跨语言实现通常也不会生成逐个相同的随机数。
-
同时调优精度与性能。 路径数、时间步、对偶变量、batchSize 和并行度应一起纳入测试。对于存在特殊连续观察规则的 Barrier、随机波动率离散敏感的 Heston,单纯提高路径数可能是低效甚至错误的优化方向。
11.4 CPU 通用框架与 Shark GPU 的区别
CPU-GPU 异构计算平台 Shark
应用:蒙特卡罗模拟定价展示了基于 Shark Graph 的 GPU 场景和雪球定价案例。该方案与本文重点介绍的
monteCarlo 等单节点 CPU 通用数值函数属于不同执行路径。不能把 Shark 示例中的 GPU
加速倍数直接作为本次三个函数的性能指标,也不能由 Shark 支持 GPU 推导出 monteCarlo 自动获得 GPU
加速。二者适合从接口灵活性、开发复杂度、硬件要求和业务吞吐目标等维度做独立评价。
11.5 如何选择实际定价方式?
在 DolphinDB 的金融工程工作流中,标准产品优先考虑经过验证的内置专用定价函数;低维定价及部分提前行权问题可考虑 PDE/FDM;高维随机因子、路径依赖、复杂定制收益及数值方法研究则适合使用通用 Monte Carlo 工具。三者并非竞争关系,而是可互相校验、按业务特点组合使用的计算方法。
最终实践原则可以概括为:先确保模型与产品条款正确,再用统计方法解释精度,最后在同等精度和同等约定下优化性能。
12. 结语
从 mcSimulate 到 mcEstimate,再到一体化的 monteCarlo,DolphinDB 将随机驱动、批量路径模拟与统计聚合封装为通用数值工具;用户可以主要通过 evolve 和 payoff 两个回调表达不同模型及合约逻辑。这一能力不仅覆盖从 European、Asian、Basket 到 Heston 的典型期权研究任务,也为自定义路径依赖合约、历史状态估值及模型数值验证提供了统一的实现入口。
在实际金融业务中,“函数能够运行”“模拟价格接近参考值”“合约现金流正确”“性能足够好”是四个不同层次的结论。建议首先用解析解和确定性测试确认实现,再用独立引擎与收敛分析控制数值风险,最后通过规范、可复现的 benchmark 评估性能。如此,通用 Monte Carlo 才能从一个灵活的研究工具,逐步发展为可靠的金融数值计算组件。
附录
附录 A 常见扩展产品与建模提示
| 产品 / 模型 | 状态与 Payoff 思路 | 建议验证方法 | 难点 |
|---|---|---|---|
| Cash/Asset Digital | GBM + 终值阈值 | BS 数字期权解析解 | 阈值不连续导致方差与离散问题 |
| Weighted Asian | 价格序列加权平均 | 独立 MC + 边界输入 | Fixing 权重、日期和已实现值 |
| Partial Asian | 仅对观察窗口求均值 | 确定性路径、独立 MC | 观察窗口映射 |
| Down-and-In/Out | 历史最小值与下障碍 | 敲入/敲出平价、独立模型 | 连续或离散触发的约定 |
| Floating-strike Lookback |
ST -min S 或 max S-ST |
高路径 MC、解析参考(若适用) | 极值取样频率 |
| Spread / Rainbow | 多资产相关 GBM | 解析特例 + 第三方数值解 | 相关性与资产币种 |
| Quanto | 标的 + FX 因子或测度修正 | 一致的跨币种定价模型 | Quanto 漂移与支付币种 |
| Cliquet | 逐期局部收益累加并设 cap/floor | 极端路径与边界单元测试 | 局部计息口径及支付时点 |
| Phoenix | 敲出、票息障碍及记忆票息状态 | 独立现金流状态机 | 观察日与记忆条件 |
| TARF | 累计目标、逐期应计与目标触发 | 独立合同状态机 | 提前终止与累计值限制 |
| 随机利率产品 | 利率因子 + 路径贴现因子 | 模型一致的独立定价器 | 曲线校准与现金流贴现 |
| American/Bermudan | MC + 额外最优停止求解 | LSM / PDE / 树方法交叉检验 | 并非内置 MC 一步完成 |
对于随机利率产品,附录 C 上传的 OPT-004 案例提供了短利率路径及累计贴现因子的数值演示,但其中 swaption
等收益仅是简化代理表达式,不应作为真实 IRS Swaption 生产定价公式。完整 Swaption
需要符合利率模型下的现金流、行权、远期利率或互换净现值定义,并以贴现测度一致的方式估值。
附录 B 参考文献与进一步阅读
-
DolphinDB,FICC 与 Equity 定价函数使用教程:标准金融产品定价接口及 Instrument/MKTDATA 的相关用法。
-
DolphinDB,eqEuropeanOptionPricer:欧式权益期权专用定价接口。
-
DolphinDB,CPU-GPU 异构计算平台 Shark 应用:蒙特卡罗模拟定价:与本文 CPU 通用 MC 工具相区别的 GPU 案例。
-
DolphinDB,pdeSolver 金融衍生品定价教程
-
Glasserman, P. (2004). Monte Carlo Methods in Financial Engineering. Springer.
-
Hull, J. C. Options, Futures, and Other Derivatives. Pearson(各版次的 MC 与奇异期权章节)。
-
Heston, S. L. (1993). “A Closed-Form Solution for Options with Stochastic Volatility with Applications to Bond and Currency Options.” The Review of Financial Studies.
-
Margrabe, W. (1978). “The Value of an Option to Exchange One Asset for Another.” The Journal of Finance.
-
Longstaff, F. A., and Schwartz, E. S. (2001). “Valuing American Options by Simulation: A Simple Least-Squares Approach.” The Review of Financial Studies.