
基于 IoT 场景的 TSBS 报告对比
本报告基于 TSBS 标准 IoT 场景,对 DolphinDB、InfluxDB 和 TimescaleDB 在写入性能、查询性能和磁盘占用方面进行了对比测试,测试覆盖 100 台至 1,000 万台设备规模。
整体来看,DolphinDB 在本次测试中综合表现优异。在五个测试场景下,DolphinDB 均保持较高的写入吞吐和较高的压缩率,且在设备规模增大后仍具有较好的读写性能和扩展能力。查询方面,DolphinDB 在多数查询项中响应时间更短,尤其在大规模设备(100万-1,000万)场景和最新值查询场景下优势更加明显。
综合测试结果表明,DolphinDB 在大规模 IoT 时序数据的高频写入、实时查询和存储效率方面表现较好,更适合面向海量设备接入和实时分析的物联网应用场景。
1. 测试场景
本次测试采用 IoT 场景的基础数据集,模拟了一家虚构货运公司旗下货车车队的业务数据,并围绕其开展数据存储与运营分析。该场景下的查询涵盖了实时状态监控与分析类,并能随车队规模(货车数量)进行扩展。数据集不仅包含每辆货车实时传输的诊断数据和运行指标,还跟踪了货车的元数据,在查询中将运行指标与诊断信息关联。同时,为了贴近真实生产环境,数据集中还引入了乱序数据,并模拟车辆离线后重新上线时产生的批量数据回补场景。
每个货车的诊断数据(diagnostics)记录包含 1 个时间戳(纳秒精度)和 3 个测量值,8 个标签值;货车的指标信息(readings)记录包含 1 个时间戳和 7 个测量值,8 个标签值。部分数据展示见图 1-1 和图 1-2。
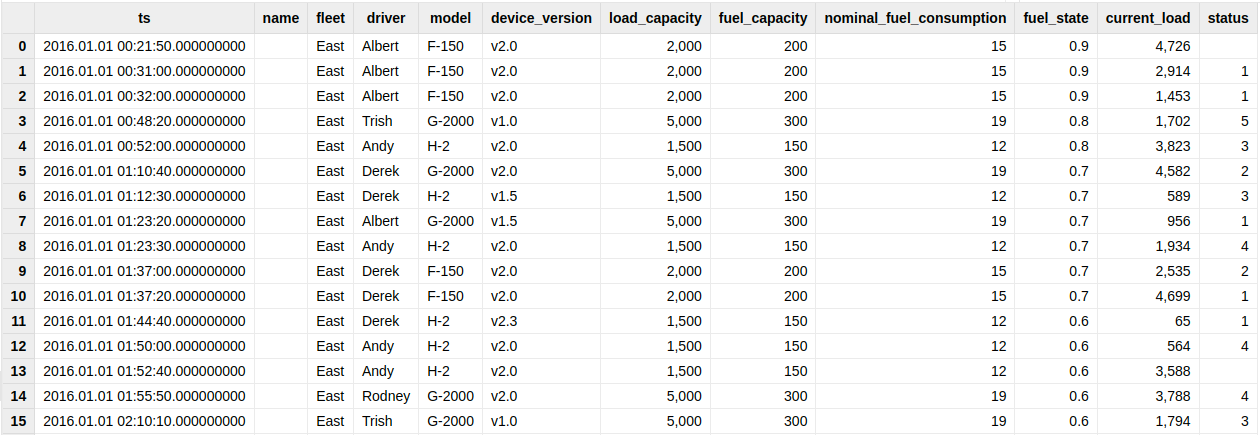
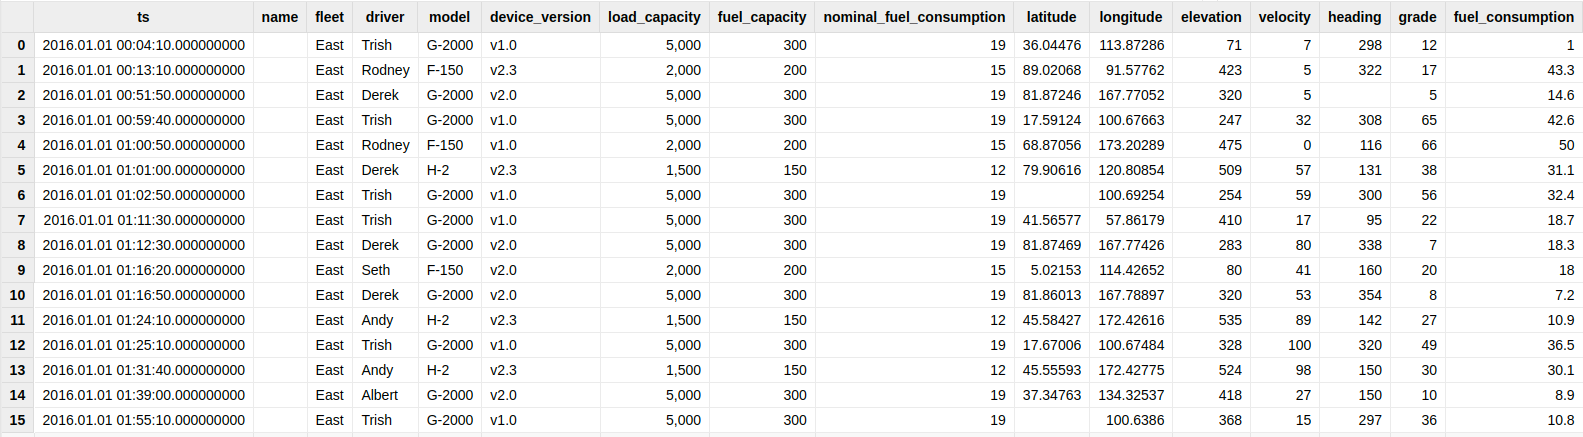
在整个基准性能评估中,涉及以下五个场景,每个场景的具体数据规模和特点见表 1-1。
表 1-1 5 个场景的具体数据规模与特点
|
场景一: 100 devices |
场景二: 4,000 devices |
场景三: 100,000 devices |
场景四: 1,000,000 devices |
场景五: 10,000,000 devices |
|
|---|---|---|---|---|---|
| 数据间隔 | 10 秒 | 10 秒 | 10 秒 | 10 秒 | 10 秒 |
| 持续时间 | 31 天 | 4天 | 3 小时 | 3 分钟 | 3 分钟 |
| 卡车数目 | 100 | 4,000 | 100,000 | 1,000,000 | 10,000,000 |
| 单个卡车记录数 | 241,145 | 31,118 | 972 | 16 | 16 |
| 数据集记录数 | 48,229,186 | 248,944,316 | 194,487,997 | 32,414,619 | 324,145,090 |
2. 环境配置
为确保本测试科学有效,三个数据库采用同一个服务器进行测试,测试环境、数据集、场景一致。
2.1 软硬件配置
本次测试服务器的软硬件配置如下:
-
硬件配置
CPU:Intel(R) Xeon(R) Silver 4216 CPU @ 2.10GHz
CPU cores:64
内存:512G(32*16 DDR4 2400 MT/s)
硬盘:1块 3.2 TB 固态硬盘 SSD
-
软件版本
DolphinDB Server V3.00.6.1
InfluxDB V1.8.10
TimescaleDB V2.10.1
注:
-
各数据库软件均为单节点。
-
这里选择了 InfluxDB V1.8.10(发布于2021年),因 2.x 版本未公开提供其 TSBS-IOT 实现。
2.2 关键配置参数
以下列出了针对 TSBS-IOT 场景各软件的关键参数,以提升测试性能。
-
DolphinDB
开启引擎块缓存。
setTSDBBlockCacheSize(50)-
InfluxDB
cache-max-memory-size = "80g"
index-version = "tsi1"
max-values-per-tag = 0
compact-full-write-cold-duration = "30s"-
TimescaleDB
按不同场景配置不同的 CHUNK_TIME,参数的设置如下表所示。
表 2-1 参数设置
| 场景一 | 场景二 | 场景三 | 场景四 | 场景五 | |
|---|---|---|---|---|---|
| 设备数目 | 100 | 4,000 | 100,000 | 1,000,000 | 10,000,000 |
| Chunk 数目 | 12 | 12 | 12 | 12 | 12 |
| Chunk 持续时间 | 2.58 天 | 8 小时 | 15 分 | 15 秒 | 15 秒 |
| CHUNK_TIME | 62h | 8h | 15m | 15s | 15s |
3. 测试结论
本文基于 TSBS 物联网场景的测试数据,对 DolphinDB、InfluxDB、TimescaleDB 在 IoT 场景中的写入和查询性能进行了对比,综合结果如下:
-
DolphinDB 综合性能最好。在 5 个测试场景下,DolphinDB 在写入吞吐、写入耗时、磁盘占用和多数查询响应时间方面整体表现最优。随着设备规模从 100 台扩展到 1,000 万台,DolphinDB 仍能保持较高的写入效率和较稳定的查询性能,尤其在大规模设备场景下优势更加明显。
-
DolphinDB 在大规模场景下优势更明显。从写入吞吐看,DolphinDB 约为 InfluxDB 的 1.9~10.7 倍,约为 TimescaleDB 的 1.9~2.6 倍;从磁盘占用看,在千万级设备场景下,InfluxDB 磁盘占用约为 DolphinDB 的 96 倍,TimescaleDB 约为 DolphinDB 的 10.7 倍。这说明在设备数量和数据规模持续增大后,DolphinDB 在写入效率和存储成本方面的优势会进一步放大。
写入性能对比:
-
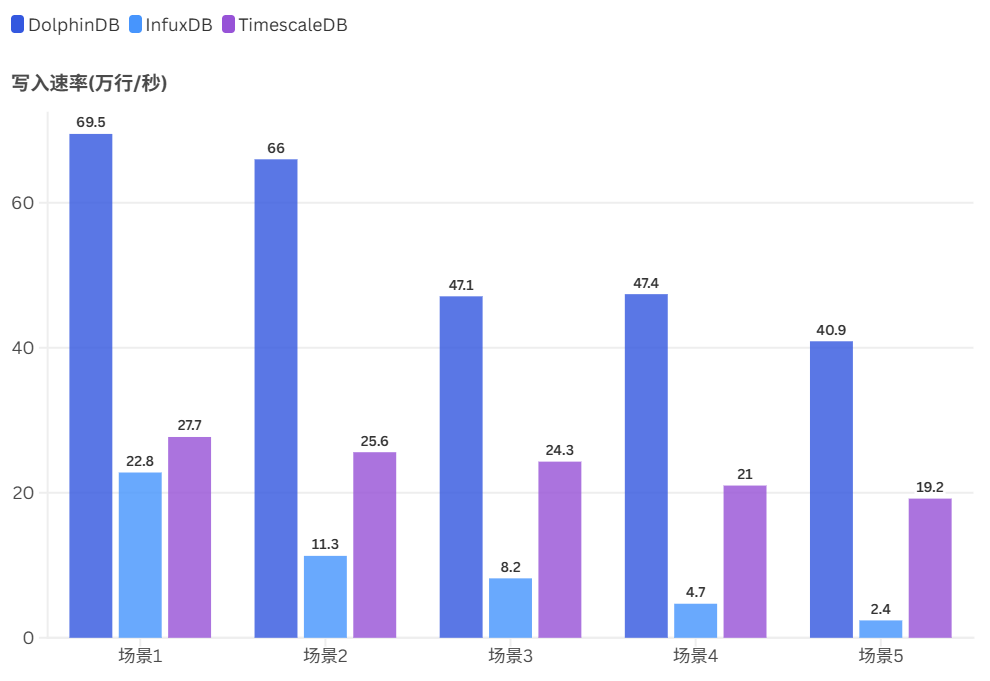
写入吞吐最高。DolphinDB 在 5 个场景中的写入速度分别约为 69.5 万行/秒、66.0 万行/秒、47.1 万行/秒、 47.4 万行/秒 和 40.9 万行/秒,均高于 InfluxDB 和 TimescaleDB。
-
总写入耗时最短。在相同数据规模下,DolphinDB 在 5 个场景中的写入总耗时均为三者中最短,说明其能够以更高效率完成数据导入。
-
磁盘占用更低。从磁盘使用情况看,DolphinDB 在各场景下均保持较低占用,尤其在大规模场景中优势更加明显。例如在场景 5 中,DolphinDB 磁盘占用为 5,355MB,显著低于 InfluxDB 的 515,990MB 和 TimescaleDB 的 57,426MB。
-
大规模写入场景性能更加稳定。当设备规模从 100 台扩展到 1,000 万台时,DolphinDB 写入吞吐虽有所下降,但仍维持在 40 万行/秒以上,说明其在大规模 IoT 数据写入场景下具有较好的规模适应能力和持续写入能力。
查询性能对比:
-
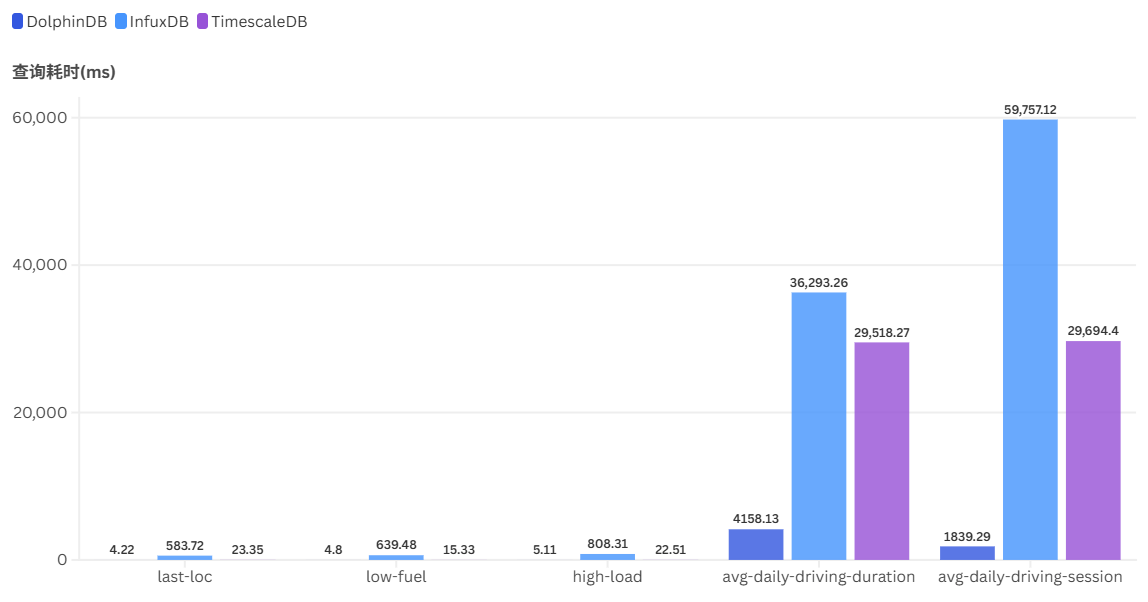
在中小规模设备场景下响应时间更低。在场景 1 和场景 2 中,DolphinDB 对全部查询项均保持了较低的平均响应时间,简单状态类查询基本稳定在毫秒级,整体吞吐能力也更高。以场景 2 为例,InfluxDB 在多数查询项上的响应时间约为 DolphinDB 的 2.6~187 倍,TimescaleDB 约为 DolphinDB 的 3.2~29.3 倍。 如图 3-2 所示,DolphinDB 在 last-loc、low-fuel、high-load 等最新值类查询和 avg-daily-driving-duration、avg-daily-driving-session 等复杂分析类查询中均具有明显优势。
-
随着设备规模增大,DolphinDB 优势更明显。在场景 3 至场景 5 中,DolphinDB 在最新值状态类查询中均明显优于 InfluxDB 和 TimescaleDB。以场景 5 的 last-loc 查询为例,DolphinDB 平均耗时为 1,439.71ms,InfluxDB 和 TimescaleDB 分别为 234,950.25ms 和 13,407.44ms,约为 DolphinDB 的 163 倍 和 9.3 倍。
-
整体来看,DolphinDB 更适合大规模 IoT 查询分析场景。其不仅在最新值状态类中查询速度更快,而且在复杂分析型查询和海量数据处理方面表现出更好的综合能力。更适合车联网、设备监控、工业物联网等海量时序数据应用场景。
4. 数据库介绍
DolphinDB 优异的写入性能得益于其自研的物联网点位管理存储引擎(IOT 引擎)。该引擎基于 LSM (Log Structured Merge Tree ) 实现,LSM 是一种分层、有序、面向磁盘的数据结构,其核心思想是将随机写入转换为顺序写入,从而大幅提升写入吞吐,以适配物联网高写入吞吐需求的场景。相较于传统的 B+ 树而言,LSM-Tree 的优势在于高吞吐写入。围绕 LSM-Tree 架构,DolphinDB 通过高效的内存管理、异步写入机制、数据压缩等对写入性能实现了进一步的优化。DolphinDB 采用 PAX 行列混合存储,并且支持多种压缩算法(如 LZ4、ZSTD、DELTA、CHIMP 等),在写入时对数据列进行压缩,大大减少了磁盘占用并提高 I/O 效率。同时 DolphinDB 支持对索引键进行哈希降维,来避免因设备数量过多导致的索引信息膨胀。
在查询方面,DolphinDB 采用“分区机制 + 分区内主索引 + 分区内二级稀疏索引”的存储机制。这种存储机制,总体上更有利于大数据的场景,但在小数据量的场景表现也不错。其优势具体表现在:
-
使用 PAX 行列混合存储模式:行列混存拥有均衡的查询性能。
-
引入了哈希降维技术(sortKeyMapping):该技术把多个索引通过哈希函数映射到合理的索引区间,大幅降低海量时间线的索引成本,很好地解决了时序数据库领域最具有挑战性的高基数(时间线数量过多)问题。
-
最新值查询优化:对于最新值查询,系统可优先从按分区维护的最新值缓存表中读取结果,避免扫描历史数据。
InfluxDB 采用自研的 TSM 存储引擎,其 TSI 时间序列索引也基于 LSM-Tree 实现。InfluxDB 1.x 按时间序列(series)组织数据,series 通常由 ,measurement、tag set 和 field key 共同确定。这种方式在不同设备量的情况下优劣势明显,其优势具体表现在:(1)在小规模设备场景下,设备数量和 tag 组合数量较少,series 数量有限,measurement/tag 索引结构相对简单,能够较快定位相关时间序列。(2)小规模数据下,热点索引和数据更容易保留在内存缓存中,查询时磁盘 I/O 较少。其劣势具体表现在:(1)随着设备数量增加,tag 组合数量增多,InfluxDB 中需要维护的时间序列数量也会快速上升,从而在查询时需要遍历更多的索引,严重降低查询性能。(2)索引结构膨胀后,运行时占用大量内存,容易导致内存不足,影响了系统稳定性。(3)在写入大量设备数据时,需要频繁更新和维护新的 series 及其索引信息,导致 InfluxDB 的写入性能明显落后。(4)高设备量时,索引和数据量会超过内存容量,导致更多的磁盘 I/O 操作,进一步降低性能。
TimescaleDB 基于 PostgreSQL 底座开发,它添加了时序特性优化,将时序数据按时间维度进行拆分,形成称为 “chunks” 的数据块,并对每个数据块应用索引来提升查询性能。其在小规模数据场景中凭借其成熟的关系型数据库功能和灵活的查询能力有一定优势。 然而,在大规模、高基数的设备数据场景中,由于其底层仍然依赖 PostgreSQL 的 Heap 行存、B-Tree 索引,查询和写入性能均受到较大限制。大量设备并发写入时,数据虽然按时间进入不同 chunk,但在每个活跃 chunk 内仍需要持续维护索引。随着设备数量增多,基于 tags_id 和 time 的 B-Tree 索引需要同时维护更多设备对应的索引区域。由于不同设备的数据会落到不同的索引叶子页,写入过程不再集中在少量热点页上,而是会在大量活跃叶子页之间切换。若这些活跃索引页的数量超过内存缓存能够有效保留的范围,索引页的复用率就会下降,进而增加磁盘页访问开销。同时,B-Tree 插入需要保持索引项有序,当目标叶子页空间不足时可能触发索引页分裂;大量分散插入还会导致随机写入增加,最终带来写放大问题。每新增一个索引,写入时都需要同步更新对应的 B-Tree,导致磁盘 I/O进一步上升。总体而言,在大规模时序数据写入时,其 I/O 效率不佳。
5. 写入性能对比
5.1 不同场景下写入性能对比
DolphinDB 在 5 个测试场景中均表现出更高的写入吞吐和更低的存储空间占用,且随着设备规模扩大,其优势更加明显。
从不同规模场景看,在 100 台和 4,000 台设备场景下,三种数据库都能完成数据写入,但 DolphinDB 的写入耗时更短,吞吐更高;在 10 万台、100 万台和 1,000 万台设备场景下,数据规模和设备基数明显增加,InfluxDB 和 TimescaleDB 写入吞吐下降更明显,而 DolphinDB 仍能维持在 40 万行/秒以上,表现出更好的大规模写入稳定性。
磁盘占用方面,DolphinDB 在各场景下整体占用更低,尤其在大规模场景中差距更加明显。以场景 5 为例,DolphinDB 磁盘占用为 5,355MB,明显低于 InfluxDB 的 515,990MB 和 TimescaleDB 的 57,426MB。这说明 DolphinDB 在高频写入的同时,也能保持较好的数据压缩和存储效率,适合大规模 IoT 数据持续写入场景。
详细测试数据见下表:
表 5-1 5个场景的写入性能
| 场景 | 数据库 | row/s | metrics/s | total times(s) | disk usage(MB) |
|---|---|---|---|---|---|
| 场景1 | DolphinDB | 694,649.91 | 3,473,344.09 | 69.429 | 732 |
| InfluxDB | 228,465.05 | 1,806,412.25 | 211.101 | 814 | |
| TimescaleDB | 277,029.85 | 1,385,186.94 | 174.094 | 9,381 | |
| 场景2 | DolphinDB | 659,963.74 | 3,299,776.69 | 377.209 | 4,001 |
| InfluxDB | 112,619.06 | 890,426.78 | 2,210.499 | 4,255 | |
| TimescaleDB | 256,418.58 | 1,282,076.60 | 970.851 | 44,472 | |
| 场景3 | DolphinDB | 471,030.21 | 2,355,129.73 | 412.899 | 2,745 |
| InfluxDB | 81,808.29 | 646,821.95 | 2,377.363 | 4,068 | |
| TimescaleDB | 242,931.30 | 1,214,645.51 | 800.588 | 33,709 | |
| 场景4 | DolphinDB | 474,296.32 | 2,371,456.42 | 68.343 | 468 |
| InfluxDB | 47,459.47 | 375,244.93 | 682.996 | 3,706 | |
| TimescaleDB | 209,829.44 | 1,049,136.05 | 154.481 | 6,085 | |
| 场景5 | DolphinDB | 408,823.72 | 2,044,103.04 | 792.873 | 5,355 |
| InfluxDB | 24,243.77 | 191,685.36 | 13,370.245 | 515,990 | |
| TimescaleDB | 191,746.56 | 958,725.50 | 1,690.487 | 57,426 |
表 5-2 DolphinDB 相对于 InfluxDB 与TimescaleDB 写入性能(metrics/s)
| DolphinDB/InfluxDB | DolphinDB/TimescaleDB | |
|---|---|---|
| 100 devices | 192.28% | 250.75% |
| 4,000 devices | 370.58% | 257.38% |
| 100,000 devices | 364.11% | 193.89% |
| 1,000,000 devices | 631.98% | 226.04% |
| 10,000,000 devices | 1,066.38% | 213.21% |
表 5-3 InfluxDB 、TimescaleDB 与 DolphinDB 磁盘占用对比
| InfluxDB/DolphinDB | TimescaleDB/DolphinDB | |
|---|---|---|
| 100 devices | 111.06% | 1,279.91% |
| 4,000 devices | 106.36% | 1,111.62% |
| 100,000 devices | 148.20% | 1,228.07% |
| 1,000,000 devices | 792.25% | 1,300.83% |
| 10,000,000 devices | 9,634.98% | 1,072.30% |
5.2 写入过程资源消耗
从表 5-4 可以看出,在 DolphinDB 写入过程中,整体资源消耗较低。场景 3、场景 4 和场景 5 的平均 CPU 开销分别为 253%、134% 和 295%,按 1 核等于 100% 计算,实际平均仅占用约 1.3 至 3 个 CPU 核心;平均内存开销分别为 11.70GB、7.95GB 和 19.85GB,相对于测试服务器 512GB 内存规模,占用比例较低;平均磁盘写 IO 维持在 37.69MB/s 至 44.79MB/s 之间。写入速度受 TSBS 并发写入数 Workers=4 的限制,当并发写入数提高时,DolphinDB 写入速度可以有较大提升。
结合前文写入性能结果,DolphinDB 在场景 3 至场景 5 中仍能保持约 40 万至 47 万 row/s 的写入吞吐,说明其在高并发、大规模 IoT 数据写入场景下,不仅写入效率较高,而且对 CPU、内存和磁盘 I/O 的资源消耗较为可控。整体来看,DolphinDB 写入过程未出现明显的单一资源瓶颈,具备较好的资源利用和持续写入能力。
表 5-4 DolphinDB写入资源耗用
| 场景 | 平均 CPU 开销(1核=100%) | 平均内存开销(GB) | 平均磁盘写 I/O(MB/s) |
|---|---|---|---|
| 场景3 | 253% | 11.70 | 40.00 |
| 场景4 | 134% | 7.95 | 37.69 |
| 场景5 | 295% | 19.85 | 44.79 |
6. 查询性能对比
每个测试使用 4 个并发进行查询,每一个查询项均重复查询 100 次。五个测试场景中,场景 1 和场景 2 各包含 12 个查询项,场景 3 包含 4 个查询项,场景 4 和场景 5 各包含 3 个查询项,共计 34 个查询项。各个数据库的性能表现总结如下:
-
DolphinDB 30 项排名第一,4 项排名第二。
-
InfluxDB 1 项排名第一,7 项排名第二,26 项排名第三。
-
TimescaleDB 3 项排名第一,23 项排名第二,8 项排名第三。
6.1 场景 1 查询性能
在场景 1 的小规模设备场景下,DolphinDB 在大多数查询项上的平均响应时间更短、查询吞吐更高,尤其在 long-driving-sessions、long-daily-sessions、avg-load、breakdown-frequency 等分析类查询中表现更稳定。整体来看,DolphinDB 不仅能够较好地支持简单状态查询,也能在复杂分组聚合和时间窗口分析查询中保持较低延迟,综合查询表现最好。
以 long-daily-sessions 为例,DolphinDB 查询性能约为 InfluxDB 和 TimescaleDB 的 4~16 倍。其 SQL 语句如下。
select name, driver
from (
    select iif(avg(velocity) > 1, 1, 0) as driving
    from readings
    where readings.ts >= 2016.01.06T21:22:42.354897
    and readings.ts < 2016.01.07T21:22:42.354897
    and name is not null and fleet = "West"
    group by bar(ts, 10m), name, driver
)
group by name, driver
having sum(driving) > 60
该查询主要用于统计车辆在较长时间范围内的持续行驶情况。查询逻辑分为两层:内层先按照 bar(ts, 10m)、name、driver 进行 10 分钟聚合,判断每个时间窗口内车辆是否处于行驶状态;外层再按照 name、driver 汇总被判定为行驶状态的时间窗口数量,并筛选出该数量超过阈值的车辆和司机组合。
性能优势分析:
-
该查询能够根据 ts 按天分区进行有效的分区裁剪,只访问相关日期分区,避免全表扫描。
-
fleet 是索引键,对于 fleet="West" 的过滤条件,DolphinDB TSDB 引擎可以利用索引信息预先排除不包含目标数据的数据块,从而减少实际读取的数据量。该优化在执行计划中表现为 TSDBIndexPrefiltering ,即基于 TSDB 索引的数据块预过滤。
-
创建 TSDB 表时,将 name、fleet 和 ts 设置为排序列,数据写入后会按照车辆名称、车队和时间排序。这样一来,相同车辆的数据在物理位置上相对集中,并按照时间先后排列。这种存储方式有利于按 name 和 driver 分组,并进行 10 分钟时间段聚合,可以减少分组过程中的数据重排和中间计算开销,提高聚合效率。
表 6-1 场景 1 查询性能
| 查询测试项 | 数据库 | mean(ms) | max(ms) | throughput(queries/s) |
|---|---|---|---|---|
| last-loc | DolphinDB | 5.40 | 7.63 | 710.56 |
| InfluxDB | 46.16 | 100.10 | 84.36 | |
| TimescaleDB | 1.92 | 27.02 | 1,830.21 | |
| low-fuel | DolphinDB | 5.55 | 8.34 | 696.85 |
| InfluxDB | 75.07 | 156.87 | 51.95 | |
| TimescaleDB | 2.05 | 39.49 | 1,711.37 | |
| high-load | DolphinDB | 6.25 | 11.50 | 610.34 |
| InfluxDB | 64.20 | 130.63 | 61.09 | |
| TimescaleDB | 2.18 | 37.84 | 1,475.11 | |
| stationary-trucks | DolphinDB | 4.70 | 17.39 | 804.71 |
| InfluxDB | 133.51 | 174.18 | 29.26 | |
| TimescaleDB | 4.88 | 25.25 | 739.41 | |
| long-driving-sessions | DolphinDB | 6.43 | 13.12 | 592.65 |
| InfluxDB | 25.69 | 70.85 | 152.54 | |
| TimescaleDB | 68.46 | 91.14 | 57.83 | |
| long-daily-sessions | DolphinDB | 14.11 | 26.55 | 270.88 |
| InfluxDB | 52.23 | 99.14 | 75.11 | |
| TimescaleDB | 232.38 | 447.21 | 16.75 | |
| avg-vs-projected-fuel-consumption | DolphinDB | 660.30 | 1062.21 | 6.02 |
| InfluxDB | 2,393.86 | 4,326.65 | 1.66 | |
| TimescaleDB | 8,564.34 | 21,685.25 | 0.46 | |
| avg-daily-driving-duration | DolphinDB | 750.10 | 1,320.51 | 5.25 |
| InfluxDB | 6,317.81 | 6,932.99 | 0.63 | |
| TimescaleDB | 5,143.83 | 11,326.46 | 0.75 | |
| avg-daily-driving-session | DolphinDB | 349.65 | 577.76 | 11.26 |
| InfluxDB | 9,372.36 | 9,896.45 | 0.43 | |
| TimescaleDB | 5,071.28 | 11,159.55 | 0.77 | |
| avg-load | DolphinDB | 466.79 | 765.95 | 8.52 |
| InfluxDB | 115,933.35 | 119,103.49 | 0.03 | |
| TimescaleDB | 2,745.15 | 6,471.68 | 1.44 | |
| daily-activity | DolphinDB | 1,176.14 | 1,771.07 | 3.36 |
| InfluxDB | 2,759.61 | 3,001.47 | 1.45 | |
| TimescaleDB | 5,365.12 | 11,704.32 | 0.74 | |
| breakdown-frequency | DolphinDB | 457.97 | 775.77 | 8.62 |
| InfluxDB | 54,796.96 | 56,346.62 | 0.07 | |
| TimescaleDB | 5,108.91 | 10,604.03 | 0.76 |
表 6-2 场景1 InfluxDB 与 TimescaleDB 相对于 DolphinDB 查询响应时间对比
| 查询类型 | InfluxDB/DolphinDB | TimescaleDB/DolphinDB |
|---|---|---|
| last-loc | 854.81% | 35.56% |
| low-fuel | 1,352.61% | 36.94% |
| high-load | 1,027.2% | 34.88% |
| stationary-trucks | 2,840.64% | 103.83% |
| long-driving-sessions | 399.53% | 1,064.70% |
| long-daily-sessions | 370.16% | 1,646.92% |
| avg-vs-projected-fuel-consumption | 362.54% | 1,297.04% |
| avg-daily-driving-duration | 842.26% | 685.75% |
| avg-daily-driving-session | 2,680.50% | 1,450.39% |
| avg-load | 24,836.30% | 588.09% |
| daily-activity | 234.63% | 456.16% |
| breakdown-frequency | 11,965.19% | 1,115.56% |
6.2 场景 2 查询性能
在场景 2 中,设备规模增加,随着设备规模和数据量上升,三种数据库的查询耗时均有所增加,但 DolphinDB 仍保持了较好的查询性能。在最新值查询和复杂分析类查询中,DolphinDB 多数情况下均优于 InfluxDB 和 TimescaleDB。特别是在 last-loc、low-fuel、high-load 等最新状态类查询中,查询耗时稳定控制在较低水平;在 avg-daily-driving-session、avg-load、breakdown-frequency 等复杂查询中,也具有明显优势。
6.2.1 最新值查询分析
以 last-loc 为例分析 SQL 优化,其 SQL 语句如下。
select * from (
    select name, driver, longitude, latitude
    from readings
    where fleet = "South"
    context by name, fleet csort ts limit -1)
where name is not null
该查询是用于查询某个车队中每辆卡车的最新位置和司机信息。查询逻辑为先从 readings 车辆传感器数据表中筛选出 fleet = "South" 的车辆数据;然后按照 name, fleet 分组,也就是按“车辆 + 车队”分组;在每个分组内部按时间列 ts 排序,并通过 limit -1 取每组最后一条记录,也就是该车辆的最新一条记录。
性能优势分析:
-
当通过 context by id+tag 列 csort 时间列 limit -1 语法来查询最新值时,where 条件包含了部分 firstSortKey 列(fleet),且使用了 firstSortKey 支持的过滤类型“=”,满足了最新值缓存表的使用条件,因此该查询能利用物联网点位管理引擎的最新值缓存,避免磁盘 IO。
6.2.2 复杂混合查询
以 avg-daily-driving-session 为例分析 SQL 优化,其 SQL 语句如下。
select
    name,
    day,
    driving_buckets * 600000.0 / session_count as avg_duration
from (
    select
        sum(is_driving) as driving_buckets,
        sum(driving_change == 1) + first(is_driving) as session_count
    from (
        select
            name,
            date(bar_ts) as day,
            bar_ts,
            is_driving,
            deltas(is_driving) as driving_change
        from (
            select avg(velocity) > 5 as is_driving
            from readings
            where ts >= 2016.01.01T00:00:00.000
              and ts < 2016.01.05T00:00:00.000
              and name is not null
            group by name, bar(ts, 10m) as bar_ts
        )
        context by name, date(bar_ts)
        csort bar_ts
    )
    group by name, day
)
where session_count > 0
该查询用于统计每个司机每天的平均连续驾驶时长。查询首先将原始数据按司机和 10 分钟时间窗口聚合,根据窗口内平均车速判断该时间段是否处于驾驶状态;随后按司机、日期对驾驶状态进行排序,并通过状态变化识别每天的驾驶 session 数量。最后根据当天处于驾驶状态的 10 分钟窗口数量计算总驾驶时长,并除以驾驶 session 数,得到每个司机每天的平均连续驾驶时长。
性能优势分析:
-
readings 表按 name 列和 ts 列分区,该查询可以根据 ts 按天分区进行有效的分区裁剪,只访问相关日期分区,避免全表扫描。
-
readings 表的排序列为 name、fleet、ts,该查询的内层聚合利用了 TSDB 表的有序存储特征,降低了分组聚合开销。
表 6-3 场景 2 查询性能
| 查询测试项 | 数据库 | mean(ms) | max(ms) | throughput(queries/s) |
|---|---|---|---|---|
| last-loc | DolphinDB | 4.22 | 8.18 | 898.31 |
| InfluxDB | 583.72 | 735.87 | 6.81 | |
| TimescaleDB | 23.35 | 239.31 | 164.10 | |
| low-fuel | DolphinDB | 4.80 | 8.03 | 798.37 |
| InfluxDB | 639.48 | 796.93 | 6.23 | |
| TimescaleDB | 15.33 | 57.04 | 252.93 | |
| high-load | DolphinDB | 5.11 | 8.81 | 734.77 |
| InfluxDB | 808.31 | 961.92 | 4.90 | |
| TimescaleDB | 22.51 | 230.20 | 172.29 | |
| stationary-trucks | DolphinDB | 42.75 | 73.00 | 91.20 |
| InfluxDB | 2,485.77 | 3,046.66 | 1.57 | |
| TimescaleDB | 138.56 | 280.16 | 28.53 | |
| long-driving-sessions | DolphinDB | 75.70 | 106.92 | 51.61 |
| InfluxDB | 282.38 | 408.30 | 14.00 | |
| TimescaleDB | 1,754.84 | 3,559.30 | 2.20 | |
| long-daily-sessions | DolphinDB | 287.18 | 654.69 | 13.67 |
| InfluxDB | 1,044.11 | 1,288.51 | 3.81 | |
| TimescaleDB | 8,412.73 | 18,275.33 | 0.47 | |
| avg-vs-projected-fuel-consumption | DolphinDB | 4,508.60 | 7,436.80 | 0.88 |
| InfluxDB | 11,655.38 | 15,793.15 | 0.34 | |
| TimescaleDB | 30,206.93 | 69,693.44 | 0.13 | |
| avg-daily-driving-duration | DolphinDB | 4,158.13 | 6,989.57 | 0.95 |
| InfluxDB | 36,293.26 | 38,184.96 | 0.11 | |
| TimescaleDB | 29,518.27 | 66,535.42 | 0.13 | |
| avg-daily-driving-session | DolphinDB | 1,839.29 | 3,141.12 | 2.15 |
| InfluxDB | 59,757.12 | 62,808.06 | 0.07 | |
| TimescaleDB | 29,694.40 | 65,882.11 | 0.13 | |
| avg-load | DolphinDB | 2,697.22 | 5,038.59 | 1.46 |
| InfluxDB | 504,725.18 | 515,162.11 | 0.01 | |
| TimescaleDB | 17,887.90 | 37,890.05 | 0.22 | |
| daily-activity | DolphinDB | 6,537.10 | 11,950.59 | 0.61 |
| InfluxDB | 5,632.81 | 6,403.07 | 0.71 | |
| TimescaleDB | 32,822.26 | 95,600.64 | 0.12 | |
| breakdown-frequency | DolphinDB | 2,633.96 | 4,814.59 | 1.51 |
| InfluxDB | 299,388.11 | 305,856.51 | 0.01 | |
| TimescaleDB | 30,038.50 | 63,655.93 | 0.13 |
表 6-4 场景 2 InfluxDB 与 TimescaleDB 相对于 DolphinDB 查询响应时间对比
| 查询类型 | InfluxDB/DolphinDB | TimescaleDB/DolphinDB |
|---|---|---|
| last-loc | 13,832.23% | 553.32% |
| low-fuel | 13,322.5% | 319.375% |
| high-load | 15,818.20% | 440.51% |
| stationary-trucks | 5,814.67% | 324.12% |
| long-driving-sessions | 373.03% | 2,318.15% |
| long-daily-sessions | 363.57% | 2,929.43% |
| avg-vs-projected-fuel-consumption | 258.51% | 669.98% |
| avg-daily-driving-duration | 872.83% | 709.89% |
| avg-daily-driving-session | 3,248.92% | 1,614.45% |
| avg-load | 18,712.79% | 663.20% |
| daily-activity | 86.17% | 502.09% |
| breakdown-frequency | 11,366.46% | 1,140.43% |
6.3 场景 3 查询性能
场景 3 中设备规模进一步扩大至 10 万台,在该场景下涉及 last-loc、low-fuel、high-load、stationary-trucks 四类查询。测试结果显示,DolphinDB 在所有查询项上的平均响应时间均明显低于 InfluxDB 和 TimescaleDB。在设备数量明显增加后,DolphinDB 仍能较好地控制最新状态查询和设备筛选类查询的执行开销,具备更好的大规模设备查询适应能力。
表 6-5 场景 3 查询性能
| 查询测试项 | 数据库 | mean(ms) | max(ms) | throughput(queries/s) |
|---|---|---|---|---|
| last-loc | DolphinDB | 66.54 | 451.45 | 59.17 |
| InfluxDB | 6,381.56 | 7,876.10 | 0.62 | |
| TimescaleDB | 225.52 | 422.33 | 17.58 | |
| low-fuel | DolphinDB | 45.37 | 67.42 | 85.41 |
| InfluxDB | 9,576.72 | 11,016.70 | 0.42 | |
| TimescaleDB | 214.55 | 365.73 | 18.28 | |
| high-load | DolphinDB | 71.87 | 450.13 | 54.44 |
| InfluxDB | 8,770.11 | 10,824.70 | 0.45 | |
| TimescaleDB | 214.19 | 401.36 | 18.57 | |
| stationary-trucks | DolphinDB | 201.59 | 559.29 | 19.39 |
| InfluxDB | 45,761.18 | 55,879.68 | 0.09 | |
| TimescaleDB | 1,316.01 | 3,090.69 | 2.97 |
注:场景 3 下 DolphinDB、InfluxDB 和 TimescaleDB 只能生成 last-loc、low-fuel、high-load、stationary-trucks 的查询 SQL。
6.4 场景 4 查询性能
在场景 4 的 100 万台设备规模下,InfluxDB 和 TimescaleDB 的响应时间相比 DolphinDB 明显更长,性能差距进一步拉大。在最新状态类查询中,DolphinDB 的平均响应时间仍保持在百毫秒级,而 InfluxDB 已上升到秒级甚至数十秒级,TimescaleDB 也明显高于 DolphinDB。说明 DolphinDB 在百万级设备规模下仍能有效支撑高基数设备状态查询。
表 6-6 场景 4 查询性能
| 查询测试项 | 数据库 | mean(ms) | max(ms) | throughput(queries/s) |
|---|---|---|---|---|
| last-loc | DolphinDB | 128.97 | 175.98 | 30.05 |
| InfluxDB | 18,470.30 | 20,192.26 | 0.22 | |
| TimescaleDB | 1,327.57 | 1,597.69 | 2.99 | |
| low-fuel | DolphinDB | 125.78 | 179.92 | 31.55 |
| InfluxDB | 12,514.69 | 14,065.66 | 0.32 | |
| TimescaleDB | 1,205.62 | 1,459.58 | 3.27 | |
| high-load | DolphinDB | 129.96 | 168.56 | 30.55 |
| InfluxDB | 28,789.58 | 30,387.20 | 0.14 | |
| TimescaleDB | 1,402.48 | 2,158.72 | 2.77 |
注:场景 4 下 DolphinDB、InfluxDB 和 TimescaleDB 只能生成 last-loc、low-fuel、high-load 的查询 SQL。
6.5 场景 5 查询性能
在场景 5 的 1000 万台设备规模下,DolphinDB 的查询性能仍明显优于 InfluxDB 和 TimescaleDB。虽然 DolphinDB 的响应时间相比前几个场景有所增加,但在最新状态类查询中仍保持在秒级范围内;相比之下,InfluxDB 查询耗时增长显著,TimescaleDB 也达到十秒级左右。整体来看,DolphinDB 在千万级设备场景下仍具备较好的查询可用性和稳定性,更适合高基数、大规模 IoT 设备状态查询场景。
表 6-7 场景 5 查询性能
| 查询测试项 | 数据库 | mean(ms) | max(ms) | throughput(queries/s) |
|---|---|---|---|---|
| last-loc | DolphinDB | 1,439.71 | 1,756.10 | 2.77 |
| InfluxDB | 234,950.25 | 269,008.90 | 0.02 | |
| TimescaleDB | 13,407.44 | 16,209.41 | 0.30 | |
| low-fuel | DolphinDB | 1,346.10 | 1,625.34 | 2.95 |
| InfluxDB | 158,430.33 | 179,486.72 | 0.03 | |
| TimescaleDB | 12,540.57 | 14,479.36 | 0.32 | |
| high-load | DolphinDB | 1,451.00 | 1,854.78 | 2.74 |
| InfluxDB | 745,830.65 | 2,775,056.38 | 0.01 | |
| TimescaleDB | 13,286.57 | 15,211.52 | 0.29 |
注:场景 5 下 DolphinDB、InfluxDB 和 TimescaleDB 只能生成 last-loc、low-fuel、high-load 的查询 SQL。
6.6 查询资源开销
由于部分查询持续时间特别短,并不能完整地看到查询过程中服务器的 CPU、内存、I/O 情况。针对场景二,以 avg-daily-driving-duration 等复杂查询为例,执行 100 次查询,记录 DolphinDB 在查询执行的整个过程中服务器 CPU、内存的开销。
表 6-8 查询资源开销结果
| 查询测试项 | 平均 CPU 开销(1核=100%) | 平均内存开销(GB) |
|---|---|---|
| avg-daily-driving-duration | 2264% | 6.98 |
| avg-daily-driving-session | 2305% | 6.19 |
| avg-load | 2353% | 6.57 |
| daily-activity | 2411% | 6.03 |
| breakdown-frequency | 2409% | 7.59 |
从查询资源开销结果来看,DolphinDB 在场景二复杂分析类查询中主要消耗 CPU 资源。avg-daily-driving-duration、avg-daily-driving-session、avg-load、daily-activity、breakdown-frequency 等查询的平均 CPU 开销整体处于较高水平,按 1 核等于 100% 计算,约使用 22~26 个 CPU 核心,说明 DolphinDB 在执行复杂聚合分析查询时能够充分利用多核并行计算能力。
内存方面,各查询的平均内存开销整体较为稳定,基本维持在 6~8GB 范围内,相对于测试服务器的内存规模占比较低,未出现明显的内存压力。这表明该类查询虽然计算量较大,但内存使用较为可控。
7. 测试总结
综合本次 TSBS IoT 场景测试结果,DolphinDB 是一款适用于物联网场景的优秀时序数据库。在单节点测试环境下,DolphinDB 在写入吞吐、查询响应时间和磁盘空间占用等方面均表现较好,具备高性能写入、高效查询和低存储成本等特点,能够有效应用于车联网、设备监控、工业物联网等大规模时序数据场景。
同时,本报告的测试结果也可作为 IoT 场景下时序数据库选型和性能评估的基准参考,为架构师在具体生产业务中的系统架构设计、容量规划和资源配置提供依据。需要说明的是,本次测试基于单节点环境完成;在实际生产环境中,DolphinDB 可通过集群部署进一步扩展写入和查询能力,在数据分区合理、负载均衡充分的情况下,整体吞吐能力可随集群节点扩展而线性提升。
进一步阅读:
-
物联网点位引擎:如何利用 IOT 引擎优化点位管理、最新值查询和海量设备数据分析。物联网点位管理引擎
-
集群教程:如何进行 DolphinDB 集群部署、扩容和高可用配置。高可用集群部署与升级
-
冷热分级:如何在低存储成本与高查询效率之间取得平衡。分级存储
附件
完整测试文件及代码:tsbs-dolphindb.zip。测试步骤参考文件包中 docs/dolphindb.md 文档。